Observabilidad para aplicaciones con IA: qué medir más allá de logs y errores
- dmoreno
- septiembre 29, 2026
- Desarrollo de software
- aplicaciones, desarrollo, ia, InteligenciaArtificial, observabilidad, software
- 0 Comments
Cuando una aplicación tradicional empieza a comportarse mal, solemos buscar señales conocidas: errores HTTP, excepciones, consumo de CPU, memoria, consultas lentas o mensajes en los logs.
Con una aplicación basada en inteligencia artificial, esas señales siguen siendo necesarias. El problema es que ya no son suficientes.
Imagina que un agente tarda 35 segundos en responder. La petición termina correctamente, no aparece ninguna excepción y la infraestructura funciona con normalidad. Desde el punto de vista de la observabilidad tradicional, quizá no haya ningún incidente.
Pero quedan muchas preguntas abiertas. ¿El modelo tardó demasiado? ¿Se realizaron más llamadas de las previstas? ¿Una herramienta respondió lentamente? ¿El agente entró en un bucle? ¿Se enviaron demasiados tokens? ¿Hubo reintentos? ¿El retrieval recuperó información irrelevante? ¿La respuesta fue técnicamente correcta pero innecesariamente cara?
La observabilidad de aplicaciones con IA necesita responder a todas esas preguntas. Y para conseguirlo debemos dejar de pensar únicamente en logs y empezar a observar la ejecución completa.
De observar servicios a observar ejecuciones
En una aplicación web convencional podemos imaginar una petición relativamente sencilla:
Usuario → API → Base de datos → Respuesta
Una aplicación con IA puede ejecutar algo mucho más parecido a esto:
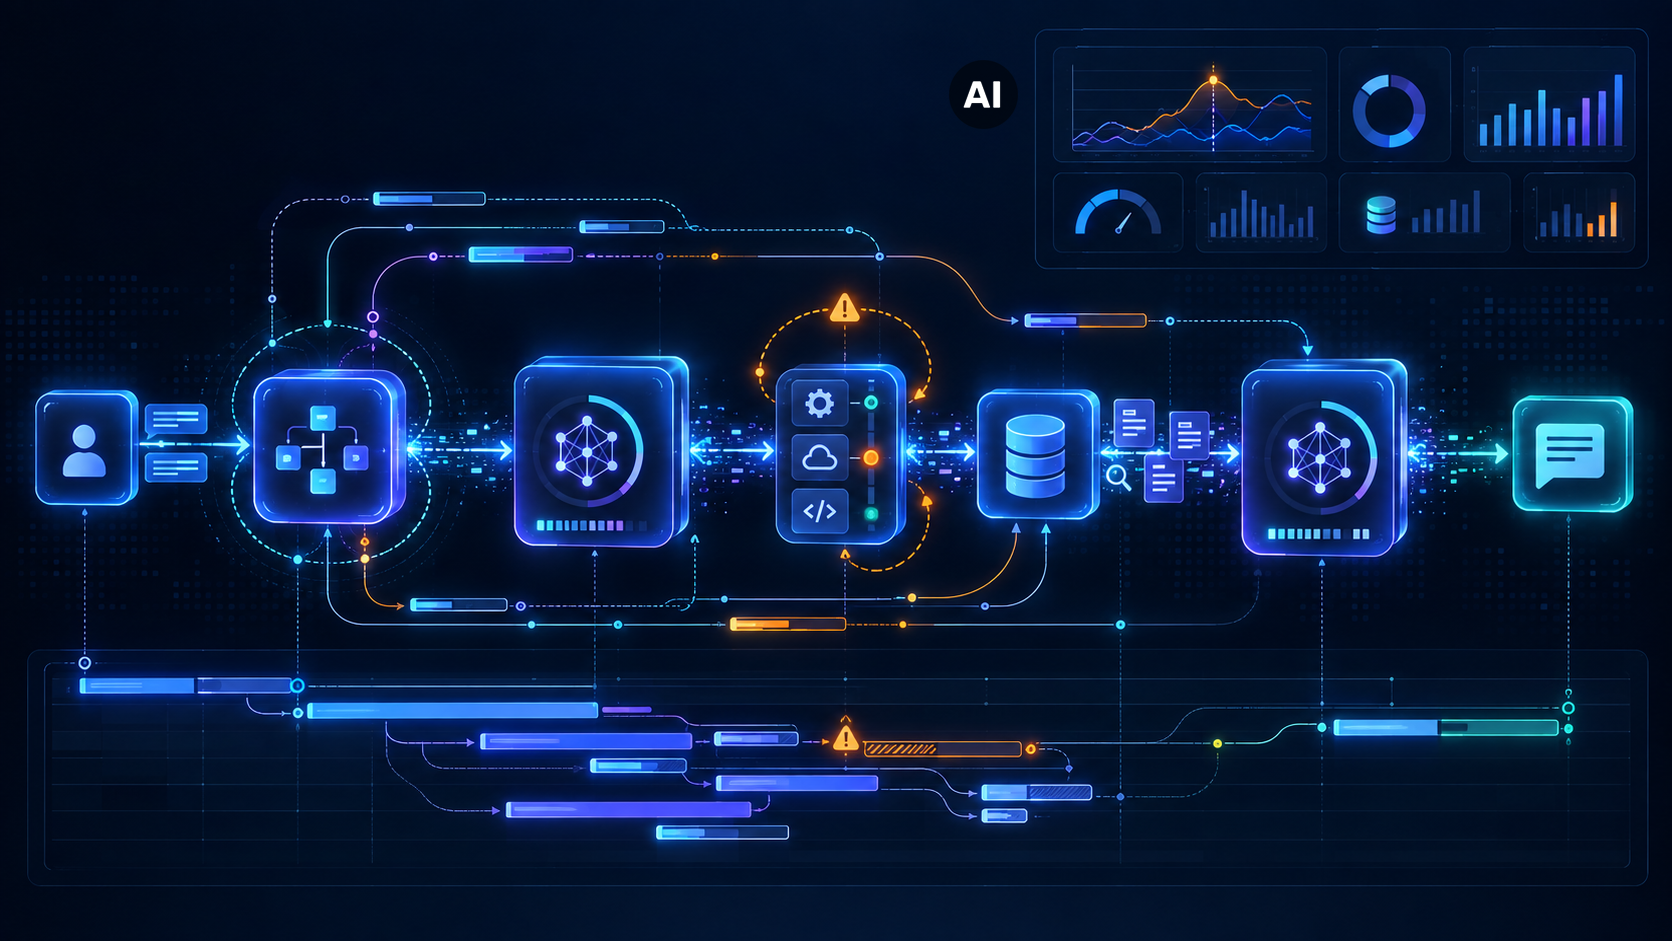
Usuario → Aplicación → LLM → Tool call → API externa → LLM → Retrieval → LLM → Respuesta
Además, cualquiera de esos pasos puede repetirse. Un agente puede decidir utilizar una herramienta, analizar su resultado, llamar a otra, volver al modelo y repetir el proceso hasta obtener una respuesta final.
Por eso el elemento fundamental de observabilidad deja de ser únicamente la petición HTTP. Necesitamos observar el workflow completo.
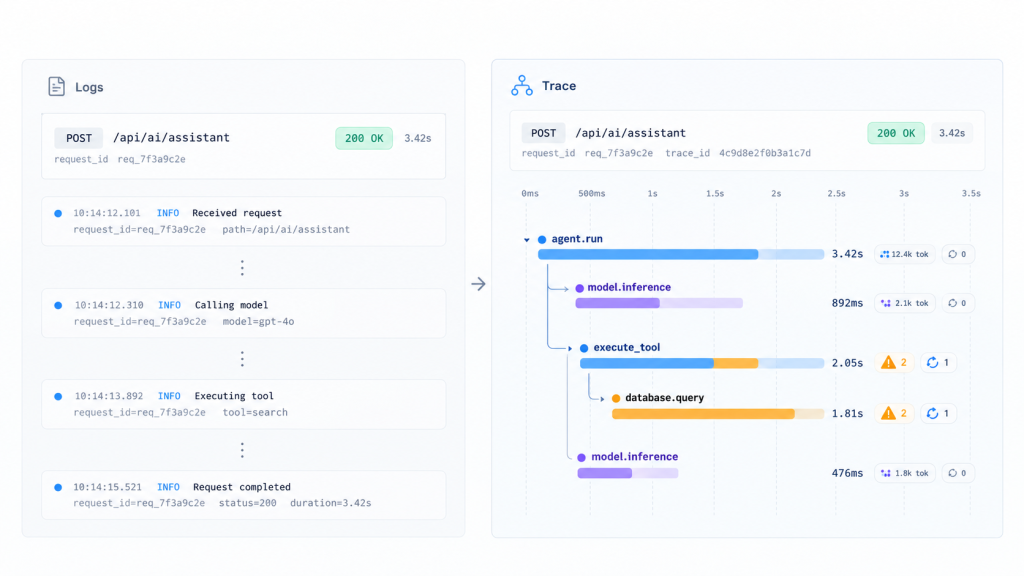
Una buena traza debería permitir reconstruir la ejecución desde que entra la petición del usuario hasta que se genera la respuesta final.
Las trazas se convierten en la pieza central
OpenTelemetry lleva años proporcionando un estándar abierto para trabajar con trazas, métricas y logs en sistemas distribuidos.
La llegada de la IA generativa ha añadido nuevas necesidades. Actualmente existen convenciones semánticas específicas para GenAI que contemplan operaciones como inferencia, retrieval, memoria y ejecución de herramientas.
La idea es sencilla: representar las operaciones de IA mediante spans dentro de una traza distribuida.
Una ejecución podría verse así:
agent.run                        4.82 s
├── model.inference              1.34 s
├── execute_tool                 0.61 s
│   └── database.query           0.48 s
└── model.inference              2.21 s
De repente, una pregunta como “¿por qué esta respuesta tardó cinco segundos?” resulta mucho más fácil de investigar.
No vemos simplemente que la petición tardó cinco segundos, vemos dónde se consumió ese tiempo. Esta diferencia es fundamental para diagnosticar agentes.
1. Latencia: medir mucho más que el tiempo total
La primera métrica evidente sigue siendo la latencia, pero medir únicamente el tiempo total de respuesta puede esconder el problema real.
Conviene separar al menos:
latencia total del workflow;
latencia de cada llamada al modelo;
latencia de cada herramienta;
latencia del retrieval;
tiempo empleado en reintentos;
tiempo hasta comenzar a recibir la respuesta cuando existe streaming.
Además, las medias pueden resultar engañosas. En producción suele ser más útil observar percentiles como p50, p95 y p99.
Un agente podría tener una latencia media perfectamente aceptable mientras un porcentaje pequeño de ejecuciones tarda varias veces más.
La pregunta interesante no es solamente: ¿Cuánto tarda mi aplicación?
Sino: ¿Qué componente está provocando las ejecuciones lentas?
Las trazas permiten responder a la segunda.
2. Tokens: una métrica técnica y económica
En aplicaciones con LLMs, los tokens son una de las señales más importantes. Conviene registrar, cuando el proveedor lo permita:
input_tokens
output_tokens
cached_tokens
reasoning_tokens
total_tokens
No solo para calcular costes. Un crecimiento inesperado del número de tokens puede revelar problemas arquitectónicos.
Por ejemplo:
prompts que acumulan demasiado contexto;
historiales de conversación que crecen indefinidamente;
documentos excesivamente grandes enviados al modelo;
agentes que realizan más iteraciones de las necesarias;
herramientas que devuelven información demasiado extensa.
Por eso resulta especialmente útil observar tokens por ejecución y no únicamente tokens totales del día.
Dos aplicaciones pueden consumir un millón de tokens diarios y comportarse de manera completamente diferente. Una puede atender 10.000 solicitudes eficientes, la otra puede atender 500 workflows extraordinariamente caros.
3. Coste por workflow
Los tokens permiten construir otra métrica operativa muy útil: coste_por_ejecucion
También podemos agregarla por:
coste_por_usuario
coste_por_agente
coste_por_modelo
coste_por_funcionalidad
coste_por_cliente
Esto permite detectar algo que la observabilidad tradicional raramente necesitaba considerar: una aplicación puede estar técnicamente sana y económicamente degradada.
No hay errores, no hay caída del servicio, la latencia incluso puede ser correcta, pero una modificación en el prompt ha duplicado el consumo de tokens. Desde la perspectiva del negocio, eso también es una regresión.
4. Tool calls: observar las decisiones del agente
Cuando introducimos agentes aparece otra dimensión importante, el modelo ya no se limita a producir texto, puede decidir ejecutar acciones.
Por ejemplo:
buscar_cliente()
consultar_pedido()
buscar_documentacion()
ejecutar_consulta_sql()
enviar_email()
Por tanto, deberíamos observar qué herramientas utiliza el agente y cómo las utiliza.
Algunas métricas interesantes son:
tool_calls_por_ejecucion
tool_error_rate
tool_latency
tool_retry_count
Pero también conviene conservar la relación causal, queremos poder reconstruir algo parecido a:
Modelo
  ↓
decide ejecutar buscar_cliente
  ↓
Tool call
  ↓
resultado
  ↓
Modelo
  ↓
decide ejecutar consultar_pedido
Esto permite distinguir un problema de infraestructura de un problema de razonamiento u orquestación. Una API puede responder perfectamente en 100 milisegundos.
Pero si el agente la llama doce veces cuando debería llamarla una, el problema está en otro sitio.
5. Reintentos y bucles
Los retries merecen atención especial. Un retry puede ser totalmente legítimo, diez retries pueden indicar un problema.
En sistemas de agentes interesa observar:
iterations_per_run
model_calls_per_run
tool_calls_per_run
retry_count
y establecer distribuciones normales para cada workflow. Si normalmente un agente resuelve una tarea utilizando dos llamadas al modelo y repentinamente empieza a necesitar siete, existe una regresión aunque todas las ejecuciones terminen correctamente.
Esta es una característica importante de los sistemas con IA: el éxito funcional no implica eficiencia operativa.
6. Errores: HTTP 500 ya no cuenta toda la historia
Los errores tradicionales continúan siendo importantes:
timeouts;
errores HTTP;
excepciones;
rate limits;
errores de autenticación;
servicios externos no disponibles.
Pero aparecen otras categorías.
Por ejemplo:
tool_selection_error
invalid_tool_arguments
max_iterations_reached
guardrail_triggered
context_limit
structured_output_validation_error
Incluso podemos tener ejecuciones técnicamente exitosas pero funcionalmente inútiles.
El modelo responde, la API devuelve 200, pero la respuesta no satisface la tarea.
Esto introduce una frontera interesante entre observabilidad y evaluación de calidad.
7. Observabilidad y evaluación no son lo mismo
Conviene separar ambos conceptos. La observabilidad intenta responder:
¿Qué ocurrió durante esta ejecución?
La evaluación intenta responder:
¿Fue buena la respuesta?
Son problemas diferentes, aunque deberían conectarse. Podemos imaginar una traza con atributos como:
trace_id
model
input_tokens
output_tokens
latency
tool_calls
retry_count
y asociarle posteriormente una evaluación:
correctness_score
relevance_score
groundedness
user_feedback
Esta combinación es extremadamente útil. Por ejemplo, podríamos descubrir que las respuestas con peor evaluación aparecen cuando:
se utiliza determinado modelo;
el retrieval devuelve pocos documentos;
el agente supera determinado número de iteraciones;
una herramienta concreta falla;
el contexto supera cierto tamaño.
Ahí es donde observabilidad y evaluación empiezan a convertirse en una herramienta real de ingeniería.
8. El modelo también debe formar parte de la telemetría
En sistemas tradicionales solemos registrar la versión del servicio desplegado. Con IA debemos hacer algo parecido con los modelos.
Resulta útil registrar información como:
model
provider
workflow_version
prompt_version
agent_version
Esto permite comparar comportamiento entre versiones. Si cambiamos un modelo podemos preguntar:
¿ha cambiado la latencia?
¿ha cambiado el consumo de tokens?
¿utiliza más herramientas?
¿ha aumentado el coste?
¿han mejorado las evaluaciones?
Sin esta información, investigar una regresión después de cambiar de modelo puede convertirse en un ejercicio de arqueología.
9. El prompt también necesita versionado
Un cambio de prompt puede modificar radicalmente el comportamiento de una aplicación sin cambiar una sola línea de código. Por eso los prompts deberían tratarse como artefactos versionados.
En lugar de depender únicamente del contenido completo del prompt, podemos registrar:
prompt_name
prompt_version
Por ejemplo:
customer_support_agent
v17
Así podemos comparar:
latencia v16 vs v17
tokens v16 vs v17
tool calls v16 vs v17
evaluaciones v16 vs v17
Esto convierte cambios aparentemente subjetivos en cambios observables.
10. Cuidado con registrar prompts completos
Aquí aparece uno de los principales riesgos. Guardar prompts y respuestas completas facilita enormemente el debugging.
Pero también puede introducir:
datos personales;
información confidencial;
credenciales;
código privado;
documentos internos;
información empresarial sensible.
Por tanto, “registrarlo todo” no debería ser la estrategia predeterminada. Una arquitectura madura debería decidir explícitamente: qué contenido se captura, durante cuánto tiempo y quién puede consultarlo.
Podemos utilizar técnicas como:
redacción de información sensible;
allowlists de atributos;
sampling;
almacenamiento separado;
controles de acceso;
periodos de retención diferentes.
En muchos casos será posible obtener observabilidad suficiente registrando metadatos y capturando contenido únicamente en determinadas ejecuciones.
11. Sampling: no todas las trazas tienen el mismo valor
Guardar cada detalle de cada ejecución puede resultar caro, por eso el sampling también es importante. Una estrategia sencilla podría conservar:
100 % de errores
100 % de ejecuciones anormalmente lentas
100 % de workflows excesivamente caros
5 % de ejecuciones normales
Así obtenemos información detallada precisamente sobre los casos más interesantes sin multiplicar innecesariamente el volumen de telemetría.
En aplicaciones con IA, además, el sampling puede depender de señales específicas:
token_count > límite
tool_calls > límite
latency > límite
retry_count > límite
evaluation_score < límite
12. Métricas agregadas para detectar problemas
Las trazas sirven para investigar ejecuciones concretas, las métricas permiten descubrir tendencias. Un dashboard básico de una aplicación con IA podría incluir:
Requests/min
Latencia p50 / p95 / p99
Model calls/run
Tool calls/run
Tool error rate
Input tokens/run
Output tokens/run
Cost/run
Retry rate
Si existe evaluación automática o feedback del usuario, podemos añadir señales de calidad. La combinación es especialmente potente.
Por ejemplo:
Latencia ↑
Tokens ↑
Tool calls ↑
Calidad =
podría indicar que el agente se ha vuelto menos eficiente sin aportar mejores resultados.
13. OpenTelemetry empieza a proporcionar un lenguaje común
Uno de los avances más interesantes es que esta telemetría empieza a normalizarse. Las convenciones de OpenTelemetry para IA generativa definen atributos y operaciones específicas para representar interacciones con modelos y otros componentes de sistemas GenAI.
Entre ellas aparecen conceptos relacionados con:
inferencia;
agentes;
ejecución de herramientas;
retrieval;
memoria;
tokens;
modelos;
latencia.
Esto es importante porque evita que cada organización invente desde cero su propio esquema. Aun así, es un terreno en evolución. En 2026 siguen existiendo discusiones sobre cómo representar mejor workflows duraderos, checkpoints, reanudaciones, delegaciones, efectos externos y otras características propias de agentes complejos.
Por eso conviene adoptar estándares, pero evitando acoplar toda la arquitectura a campos experimentales sin una capa propia de abstracción.
14. Los SDK de agentes ya incorporan tracing
La observabilidad tampoco tiene que construirse completamente desde cero, frameworks y SDK modernos empiezan a incorporar tracing directamente. Por ejemplo, el Agents SDK de OpenAI registra eventos relacionados con generaciones del modelo, llamadas a herramientas, handoffs, guardrails y otros elementos de una ejecución. También permite obtener información agregada sobre uso de tokens durante un run. Esto reduce considerablemente el esfuerzo necesario para empezar.
Pero disponer de tracing automático no elimina la necesidad de diseñar una estrategia de observabilidad.
Seguimos teniendo que decidir:
qué métricas importan;
qué atributos necesitamos;
qué alertas tienen sentido;
qué datos podemos almacenar;
cómo relacionamos telemetría técnica con resultados de negocio.
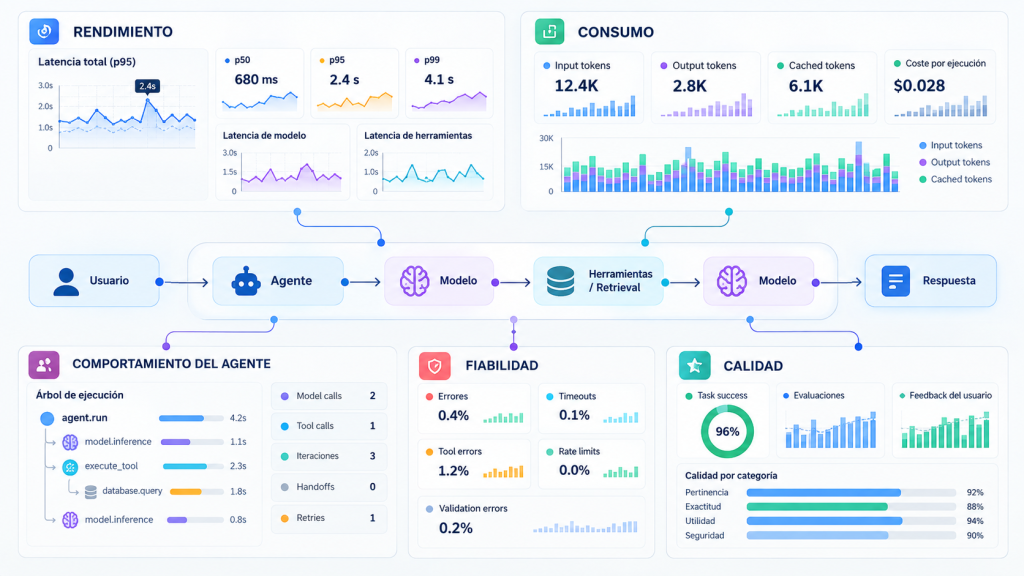
15. Un modelo práctico de observabilidad para IA
Una forma sencilla de empezar consiste en dividir las señales en cinco grupos.
Rendimiento
latency
time_to_first_token
model_latency
tool_latency
retrieval_latency
Consumo
input_tokens
output_tokens
cached_tokens
model_calls
cost
Comportamiento del agente
iterations
tool_calls
handoffs
retries
Fiabilidad
errors
timeouts
tool_errors
rate_limits
validation_errors
Calidad
evaluations
user_feedback
task_success
No todas las aplicaciones necesitan todas las métricas.
La pregunta debe ser: ¿Qué información necesitaríamos mañana para explicar una ejecución incorrecta, lenta o demasiado cara?
La respuesta define buena parte de la telemetría que deberíamos implementar hoy.
De “¿hay errores?” a “¿qué ocurrió realmente?”
Ese es probablemente el cambio conceptual más importante. La observabilidad tradicional suele empezar preguntando:
¿Está funcionando el sistema?
En aplicaciones con IA necesitamos preguntas adicionales:
¿Qué hizo exactamente?
¿Por qué tardó tanto?
¿Qué herramientas utilizó?
¿Cuántos tokens consumió?
¿Cuánto costó?
¿Cuántas veces lo intentó?
¿Qué versión del modelo y del prompt utilizó?
¿Y el resultado fue realmente útil?
Los logs continúan siendo necesarios, las métricas continúan siendo necesarias, las trazas continúan siendo necesarias, pero la unidad que necesitamos comprender ha cambiado. Ya no observamos únicamente servicios.
Observamos ejecuciones inteligentes compuestas por decisiones, modelos, herramientas y datos.
Y cuanto más autónomos sean nuestros agentes, más importante será poder reconstruir exactamente qué hicieron. Porque cuando un agente falle en producción, saber que la API devolvió 200 OK probablemente será la parte menos interesante del incidente.
REFERENCIAS
- OpenTelemetry — Inside the LLM Call: GenAI Observability with OpenTelemetry (2026): https://opentelemetry.io/blog/2026/genai-observability/
- OpenTelemetry — Semantic conventions for generative client AI spans: https://github.com/open-telemetry/semantic-conventions-genai/blob/main/docs/gen-ai/gen-ai-spans.md
- OpenTelemetry — Semantic Conventions 1.44.0: https://opentelemetry.io/docs/specs/semconv/
- OpenAI Agents SDK — Tracing: https://openai.github.io/openai-agents-python/tracing/
- OpenAI Agents SDK — Usage: https://openai.github.io/openai-agents-python/usage/
- OpenTelemetry GenAI — Proposal: observability semantics for durable agentic runtime execution (Issue #462, 2026): https://github.com/open-telemetry/semantic-conventions-genai/issues/462