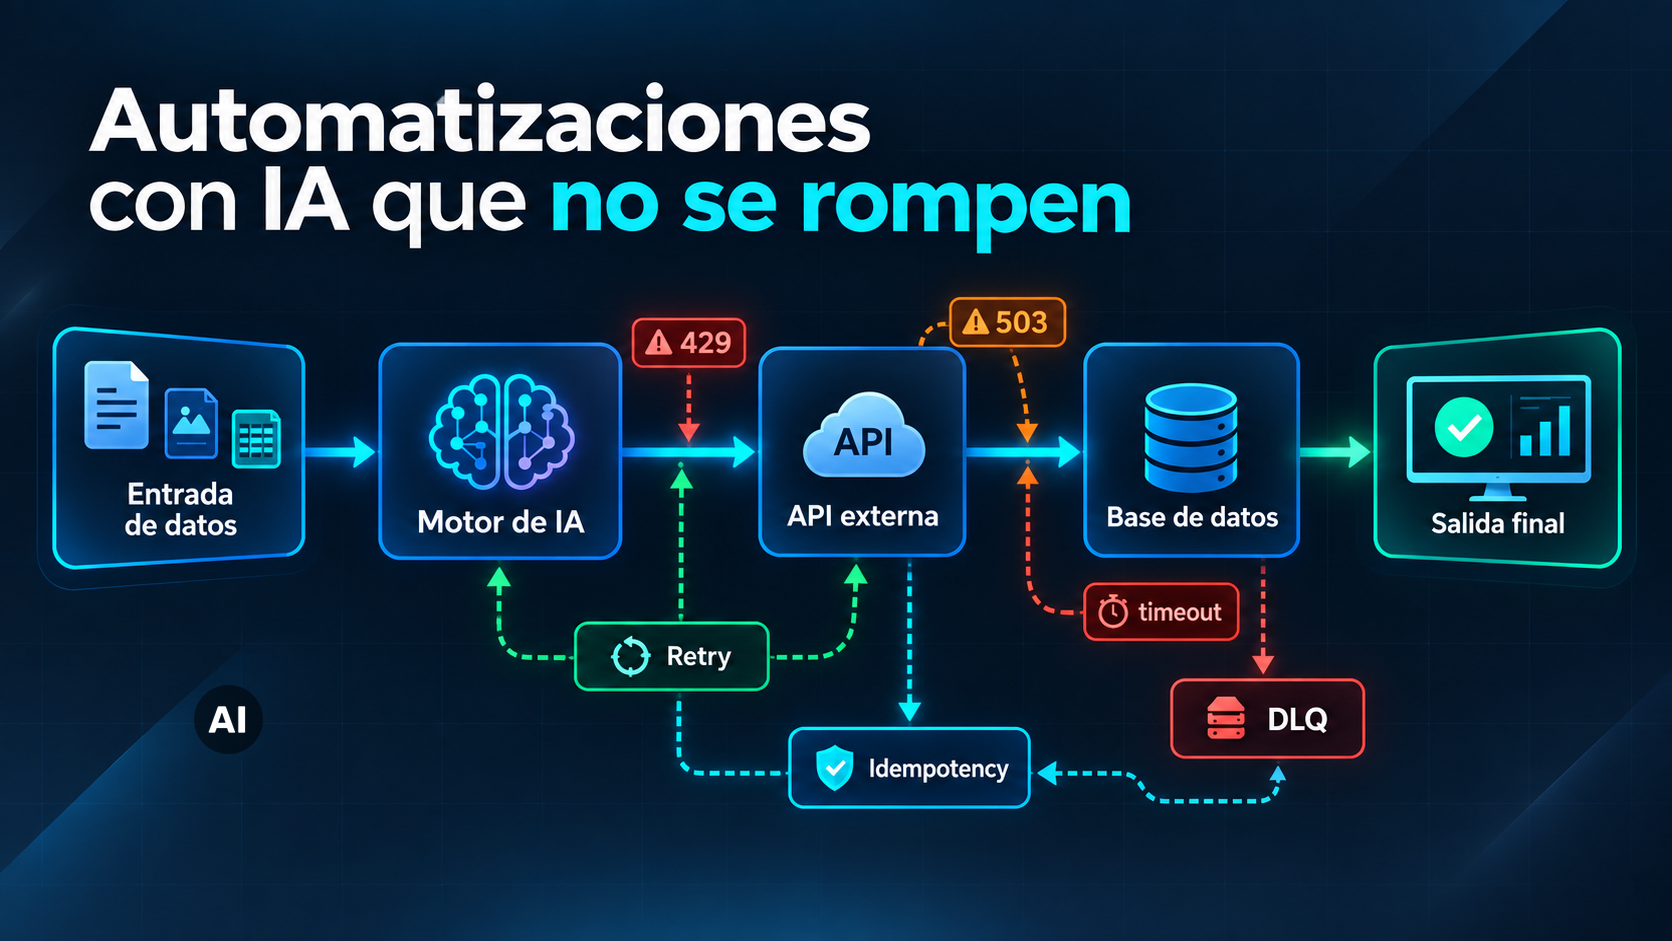
Automatizaciones con IA que no se rompen: reintentos, idempotencia y control de errores
- dmoreno
- septiembre 23, 2026
- Automatización
- Automatización, desarrollo, ia, idempotencia, InteligenciaArtificial
- 0 Comments
Conectar un modelo de inteligencia artificial a una API y conseguir que una demostración funcione suele ser relativamente sencillo. Conseguir que esa misma automatización siga funcionando cuando aparecen timeouts, límites de uso, respuestas duplicadas, servicios caídos o ejecuciones interrumpidas es otra historia.
En producción, una automatización con inteligencia artificial no debería diseñarse suponiendo que todos sus pasos terminarán correctamente. Hay que partir de la hipótesis contraria: alguno fallará.
La diferencia entre una automatización frágil y una robusta no está únicamente en la calidad del modelo. Está en cómo responde el sistema cuando una dependencia deja de contestar, una petición llega dos veces, un proceso muere a mitad de ejecución o no sabemos con certeza si una operación llegó a completarse.
La buena noticia es que no tenemos que inventar soluciones nuevas para todos estos problemas. Muchos de los patrones que necesitamos proceden de décadas de ingeniería de sistemas distribuidos: reintentos controlados, idempotencia, colas de errores, observabilidad, compensación y escalado humano.
El verdadero problema: una ejecución no es una sola operación
Imagina una automatización aparentemente sencilla:
- llega un formulario de un cliente;
- un modelo de IA clasifica la solicitud;
- se consulta información en el CRM;
- se genera una respuesta;
- se actualiza el CRM;
- se envía un correo;
- se registra el resultado.
Ahora supongamos que el paso 6 devuelve un timeout.
¿Qué significa realmente?
Podría significar que el correo nunca se envió. Pero también podría significar que el servidor sí lo envió y que la respuesta se perdió antes de llegar a nuestra automatización.
Si simplemente repetimos el paso, podríamos enviar el mensaje dos veces.
Este problema se repite constantemente en sistemas distribuidos: no siempre podemos distinguir entre “la operación falló” y “la operación terminó, pero no recibí confirmación”.
Por eso una arquitectura robusta necesita responder, como mínimo, a estas preguntas:
- ¿Qué errores merece la pena reintentar?
- ¿Cuántas veces?
- ¿Con qué intervalo?
- ¿Qué ocurre si la misma operación se ejecuta dos veces?
- ¿Cómo aislamos los trabajos que nunca terminan correctamente?
- ¿Cómo reconstruimos después qué ocurrió?
- ¿Cuándo debe intervenir una persona?
1. No todos los errores deben reintentarse
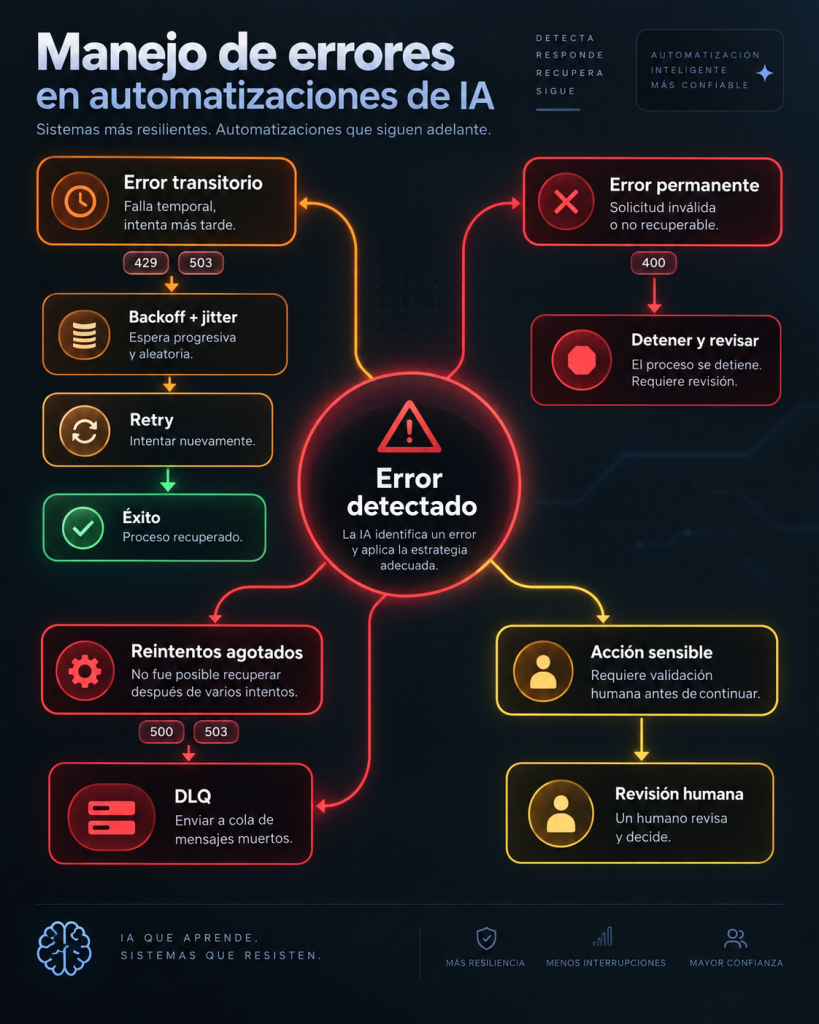
Uno de los errores más habituales en automatización consiste en envolver cualquier fallo en un bucle de reintentos, no funciona.
Hay errores transitorios, que pueden desaparecer solos, y errores permanentes, que seguirán ocurriendo independientemente de cuántas veces repitamos la operación.
Una respuesta 503 Service Unavailable, un timeout o determinados errores 429 Too Many Requests suelen ser candidatos razonables para un nuevo intento.
Una petición con parámetros inválidos normalmente no lo es. La documentación de Google Cloud recomienda utilizar reintentos para errores transitorios, limitar el número de intentos y aplicar exponential backoff en lugar de repetir las solicitudes inmediatamente.
Una política simplificada podría ser:
| Error | Acción habitual |
|---|---|
400 Bad Request | No reintentar. Corregir los datos. |
401/403 | No reintentar automáticamente. Revisar autenticación o permisos. |
408 Timeout | Reintentar de forma controlada. |
409 Conflict | Depende de la operación; revisar concurrencia o idempotencia. |
429 Too Many Requests | Esperar y reintentar respetando los límites del servicio. |
500/502/503/504 | Reintentar con límite si la operación lo permite. |
Esta tabla es una guía, no una ley universal. Cada API tiene su propio contrato y conviene seguir su documentación específica.
2. Exponential backoff: fallar sin empeorar el problema
Cuando un servicio está saturado, enviar otra petición inmediatamente puede aumentar la saturación.
Por eso se utiliza el exponential backoff: después de cada fallo incrementamos progresivamente el tiempo antes del siguiente intento.
Una secuencia sencilla podría ser:
1 s → 2 s → 4 s → 8 s → 16 s
Pero todavía existe un problema.
Si mil automatizaciones fallan simultáneamente y todas utilizan exactamente la misma secuencia, las mil volverán a atacar al servicio al mismo tiempo. Para evitarlo se añade jitter: una pequeña componente aleatoria al tiempo de espera.
Google Cloud describe precisamente este patrón de truncated exponential backoff with jitter, que además establece un límite máximo en lugar de seguir reintentando indefinidamente.
Conceptualmente:
delay = min(maxDelay, exponentialDelay + randomJitter)La idea importante no es la fórmula exacta, sino estas cuatro reglas:
- aumenta progresivamente la espera;
- introduce aleatoriedad;
- limita el número total de intentos;
- define qué errores pueden activar un reintento.
Un retry infinito no es resiliencia. Es un incidente esperando ocurrir.
3. Idempotencia: repetir sin duplicar efectos
Los reintentos introducen inmediatamente otro problema: una operación puede terminar ejecutándose más de una vez. Aquí entra la idempotencia. Una operación es idempotente cuando ejecutarla varias veces produce, desde el punto de vista del sistema, el mismo resultado que ejecutarla una sola vez.
Consultar un registro suele ser idempotente.
“Establecer el estado del pedido a Procesado” puede diseñarse como una operación idempotente.
“Incrementar el saldo en 100 euros” no lo es automáticamente.
“Enviar otro correo” tampoco.
Para operaciones con efectos secundarios, una estrategia habitual es asignar una clave de idempotencia única a la operación lógica.
Por ejemplo:
customer-9281-invoice-2026-09Si el sistema recibe dos peticiones con esa misma clave, debe reconocer que ambas representan la misma operación y evitar ejecutar el efecto dos veces. Stripe utiliza este patrón explícitamente: sus APIs permiten utilizar claves de idempotencia para repetir solicitudes sin crear accidentalmente un segundo objeto o repetir una operación.
En una arquitectura propia podemos aplicar algo parecido:
1. Recibir operación con idempotency_key
2. Buscar la clave en almacenamiento
3. Si ya terminó:
      devolver resultado anterior
4. Si está en proceso:
      evitar ejecución concurrente
5. Si no existe:
      registrar operación
      ejecutar
      guardar resultado
La clave de idempotencia debería representar la intención del negocio, no simplemente cada petición HTTP. Si generamos una clave nueva en cada reintento, hemos destruido precisamente la protección que buscábamos.
4. Diseña para “al menos una vez”, no para un mundo perfecto
En sistemas distribuidos es habitual trabajar con mecanismos de entrega que pueden procesar un mensaje más de una vez. Por ejemplo, la documentación de Amazon SQS advierte de que, dependiendo del procesamiento y de los tiempos de visibilidad, un mensaje puede volver a entregarse y ser procesado de nuevo. La consecuencia arquitectónica es importante: el consumidor también debe estar preparado para duplicados.
No basta con intentar evitar que aparezcan. Un flujo robusto debería almacenar algún identificador estable del evento o trabajo:
event_id = 7ca1...Antes de ejecutar un efecto irreversible:
if event_id already_processed:
    return previous_result
Este patrón resulta especialmente importante cuando conectamos automatizaciones, webhooks, colas y agentes de IA.
5. Cuando los reintentos se agotan: Dead-Letter Queue
¿Qué hacemos con una operación que ha fallado cinco veces?
La peor opción suele ser seguir intentándolo eternamente. Otra mala opción es descartarla silenciosamente. Una solución clásica es moverla a una Dead-Letter Queue, o DLQ.
AWS define las DLQ como colas destinadas a recibir mensajes que una cola de origen no ha conseguido procesar correctamente. Esto permite aislar los casos fallidos, analizarlos y posteriormente reprocesarlos si procede.
El flujo queda así:
Trabajo
  ↓
Procesamiento
  ↓
¿Éxito?
  ├── Sí → Terminado
  └── No
       ↓
     Retry
       ↓
¿Superó el límite?
  ├── No → Nuevo intento
  └── Sí → DLQ
Una DLQ no debería convertirse en un cementerio olvidado.
Necesita, al menos:
- alertas cuando aumenta el número de mensajes;
- motivo del fallo;
- número de intentos;
- timestamps;
- identificador de correlación;
- payload suficiente para diagnosticar el problema;
- mecanismo controlado de reprocesamiento.
Si un mensaje termina en la DLQ y nadie lo observa, hemos convertido un error visible en un error silencioso.
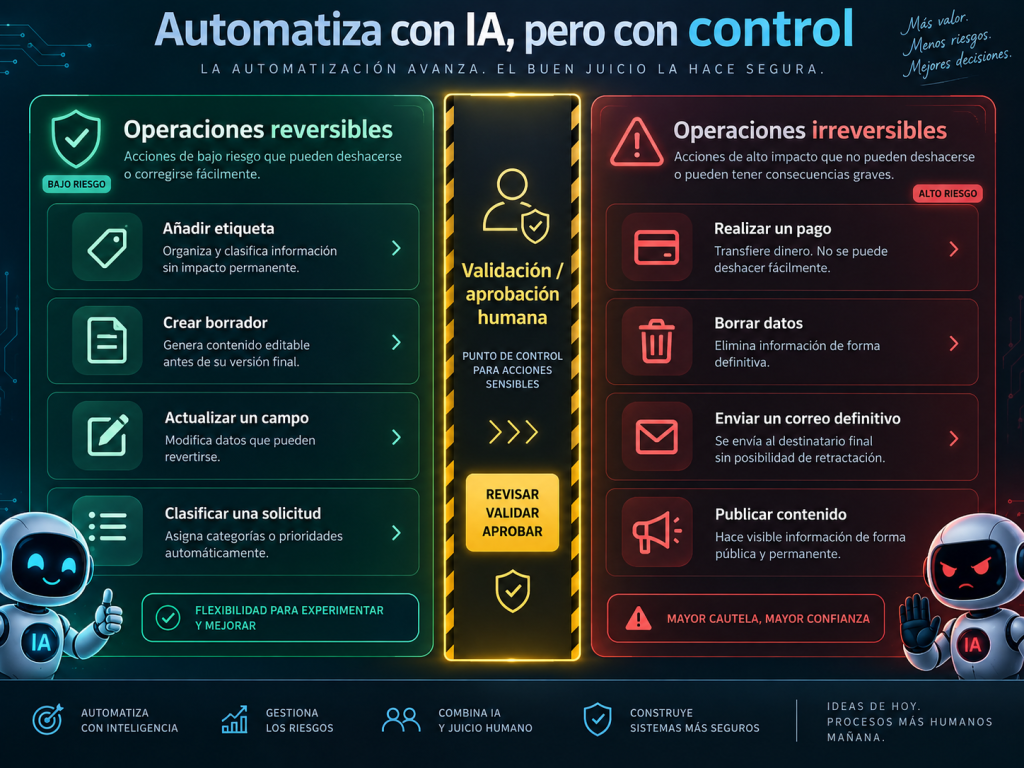
6. Operaciones reversibles e irreversibles
Aquí aparece una distinción crítica para cualquier automatización con IA. No todas las acciones tienen el mismo nivel de riesgo.
Operaciones fácilmente reversibles
Por ejemplo:
- añadir una etiqueta interna;
- actualizar un campo temporal;
- crear un borrador;
- generar una clasificación;
- guardar una recomendación pendiente de revisión.
Estas operaciones permiten más margen para automatizar y corregir después.
Operaciones difíciles o imposibles de revertir
Por ejemplo:
- efectuar un pago;
- enviar definitivamente un correo;
- borrar información;
- cancelar un servicio;
- modificar permisos;
- publicar contenido;
- comunicar una decisión a un cliente.
En estos casos deberíamos elevar considerablemente las garantías.
Una posible estrategia consiste en separar decisión y ejecución:
IA propone acción
       ↓
Validaciones deterministas
       ↓
¿Acción sensible?
  ├── No → Ejecutar
  └── Sí → Aprobación / controles adicionales
La IA puede ser excelente generando, clasificando o proponiendo. Pero una acción irreversible necesita una frontera clara donde entren reglas deterministas, permisos, políticas o supervisión humana.
7. Las transacciones distribuidas requieren compensación
Otro escenario problemático aparece cuando una automatización ejecuta varias operaciones y solo algunas terminan correctamente.
Supongamos:
- creamos un cliente;
- generamos una factura;
- realizamos un cargo;
- actualizamos el CRM.
Si el paso 4 falla, no podemos simplemente “hacer rollback” de todo como si se tratara de una única transacción SQL.
Los sistemas externos ya han cambiado. En estas situaciones podemos utilizar acciones compensatorias.
Por ejemplo:
Crear reserva        → compensación: cancelar reserva
Bloquear inventario  → compensación: liberar inventario
Crear recurso        → compensación: eliminar recurso
Sin embargo, no todas las operaciones tienen una compensación perfecta. No podemos “desenviar” un correo que alguien ya ha leído.
Por eso conviene modelar explícitamente cada paso indicando:
operación
reversible: sí/no
idempotente: sí/no
estrategia_retry
acción_compensatoria
requiere_aprobación
Esta pequeña disciplina transforma considerablemente el diseño del flujo.
8. Observabilidad: poder responder “qué ocurrió”
Una automatización que únicamente escribe mensajes como:
ERROR: Something went wronges casi imposible de operar.
Necesitamos poder reconstruir una ejecución completa. OpenTelemetry plantea un modelo vendor-neutral de observabilidad basado en señales como traces, metrics y logs.
Para una automatización con IA resulta especialmente útil asignar un identificador de correlación a cada ejecución:
correlation_id = auto_9284ab...Ese identificador debería acompañar a todos los pasos:
Webhook recibido
IA ejecutada
CRM consultado
Retry 1
Retry 2
Correo enviado
Registro actualizado
Así podemos responder preguntas operativas reales:
- ¿Cuánto tarda cada tipo de ejecución?
- ¿Qué API provoca más errores?
- ¿Cuántos reintentos necesitamos de media?
- ¿Qué porcentaje termina en la DLQ?
- ¿Qué modelos o herramientas fallan con mayor frecuencia?
- ¿Qué automatizaciones requieren más intervención humana?
Los logs explican eventos concretos. Las métricas revelan tendencias. Las trazas reconstruyen el recorrido.
Necesitamos las tres perspectivas.
9. Escalado humano como parte de la arquitectura
En muchas automatizaciones con IA, “pedir ayuda a una persona” se considera un fracaso. No debería ser así, el escalado humano es un mecanismo de control.
Debería activarse deliberadamente cuando:
- se supera el número máximo de reintentos;
- existe ambigüedad sobre si una acción irreversible se completó;
- la confianza del sistema es insuficiente;
- faltan datos;
- aparecen situaciones no contempladas;
- una política de negocio exige aprobación;
- el coste potencial del error supera el coste de revisión.
Una buena automatización no intenta eliminar a la persona de todos los caminos. Intenta reservar su atención para los casos donde realmente aporta valor.
Una arquitectura práctica
Una arquitectura robusta podría adoptar esta secuencia:
Entrada
  ↓
Validación
  ↓
Generar event_id / idempotency_key
  ↓
Clasificación o razonamiento con IA
  ↓
Validación de reglas
  ↓
Ejecución
  ↓
¿Fallo transitorio?
  ├── Sí → Backoff + jitter → Retry
  └── No
        ↓
¿Requiere intervención?
  ├── Sí → Escalado humano
  └── No → DLQ
Y transversalmente:
Logs + métricas + trazas + correlation_idCada componente cubre un problema diferente:
- Retry: tolera fallos temporales.
- Backoff + jitter: evita amplificar una caída.
- Idempotencia: evita duplicar efectos.
- DLQ: contiene los fallos persistentes.
- Observabilidad: permite investigar.
- Compensación: gestiona ejecuciones parciales.
- Escalado humano: protege decisiones sensibles.
Ninguno sustituye a los demás.
Checklist antes de poner una automatización con IA en producción
Antes de activar un flujo importante, deberíamos poder responder claramente:
- ¿Qué ocurre si cada API deja de responder?
- ¿Qué errores reintentamos y cuáles no?
- ¿Tenemos un límite máximo de reintentos?
- ¿Aplicamos backoff y jitter?
- ¿Puede una petición repetirse sin duplicar efectos?
- ¿Disponemos de claves de idempotencia o identificadores de eventos?
- ¿Qué ocurre con un trabajo que nunca termina correctamente?
- ¿Tenemos DLQ o un mecanismo equivalente?
- ¿Podemos reconstruir una ejecución completa?
- ¿Existe un correlation ID?
- ¿Tenemos métricas y alertas?
- ¿Sabemos qué acciones son reversibles?
- ¿Qué ocurre si solo se completa la mitad del proceso?
- ¿Existe una operación compensatoria?
- ¿Qué acciones requieren revisión humana?
Si varias respuestas son “no lo sé”, la automatización probablemente todavía es un prototipo.
Conclusión
Una automatización robusta no es aquella que nunca falla, eso no existe. Es aquella que falla de forma controlada.
Sabe distinguir un error temporal de uno permanente. Puede repetir una operación sin producir duplicados. Aísla los trabajos problemáticos. Conserva suficiente información para entender qué ocurrió. Evita repetir ciegamente acciones irreversibles y sabe cuándo detenerse para pedir intervención humana.
La inteligencia artificial puede aportar razonamiento, flexibilidad y capacidad de adaptación. Pero la fiabilidad sigue dependiendo de la arquitectura.
Y en producción, diseñar correctamente el segundo intento suele ser mucho más importante que celebrar que el primero funcionó.
REFERENCIAS
- Google Cloud IAM — Retry failed requests — https://docs.cloud.google.com/iam/docs/retry-strategy — Backoff exponencial truncado con jitter y límites de reintento.
- Stripe API — Idempotent requests — https://docs.stripe.com/api/idempotent_requests — Uso de claves de idempotencia para repetir solicitudes sin duplicar efectos.
- Amazon SQS — Using dead-letter queues — https://docs.aws.amazon.com/AWSSimpleQueueService/latest/SQSDeveloperGuide/sqs-dead-letter-queues.html — Patrón DLQ para aislar y reprocesar mensajes que fallan repetidamente.
- OpenTelemetry — Documentation — https://opentelemetry.io/docs/ — Observabilidad vendor-neutral con trazas, métricas y logs.
- Google Cloud Application Integration — Error handling strategies — https://docs.cloud.google.com/application-integration/docs/error-handling-strategy — Estrategias de retry y manejo de errores en integraciones.