SQL con inteligencia artificial: cómo preparar tus datos para consultas fiables en lenguaje natural
- dmoreno
- septiembre 15, 2026
- Bases de datos
- base de datos, BI, ia, InteligenciaArtificial, Modelo de Lenguaje, software, SQL
- 0 Comments
Preguntar a una base de datos en lenguaje natural ya no es una demostración futurista. Cada vez más herramientas permiten escribir una pregunta como “¿qué productos aumentaron sus ventas durante el último trimestre?” y obtener como respuesta una consulta SQL, una tabla o incluso una visualización.
El problema aparece cuando pasamos de la demo a producción.
Una consulta puede ser SQL perfectamente válido y, aun así, responder mal a la pregunta de negocio. Puede utilizar una fecha incorrecta, unir tablas por una relación equivocada, duplicar importes, interpretar “cliente activo” de forma distinta a la organización o calcular ingresos con una fórmula diferente a la que utiliza Finanzas.
Por eso, construir un buen sistema de lenguaje natural a SQL —NL→SQL o text-to-SQL— no consiste únicamente en elegir un modelo potente. También exige preparar los datos para que la IA pueda entenderlos.
Las plataformas actuales están evolucionando precisamente en esa dirección. Snowflake utiliza vistas semánticas para representar entidades, dimensiones, métricas y relaciones; Databricks permite enriquecer sus agentes Genie con instrucciones, consultas de ejemplo y activos confiables; BigQuery utiliza metadatos de su catálogo para localizar los conjuntos adecuados; y Microsoft recomienda esquemas con nombres suficientemente descriptivos para que Copilot pueda interpretar mejor la base de datos.
La conclusión es importante: la calidad del SQL generado por IA empieza mucho antes del prompt.
El problema de darle a la IA solamente el esquema
Imaginemos una base de datos con estas tablas:
tb_cli
tb_mov
tb_prd
Y columnas como:
id_cli
f_mov
imp_n
st
tp
Para una persona que conoce el sistema desde hace años quizá sea suficiente. Para un modelo de IA, la información disponible es extremadamente pobre.
¿Qué significa st?
¿Estado de la operación? ¿Estado del cliente? ¿Provincia?
¿imp_n representa importe neto, importe nominal o importe sin impuestos?
¿Una fila de tb_mov corresponde a una venta, a una línea de factura o a un movimiento de inventario?
El modelo puede intentar deducirlo. Y precisamente ahí empieza el riesgo.
Un sistema NL→SQL fiable debe reducir al mínimo las situaciones en las que el modelo tenga que adivinar.
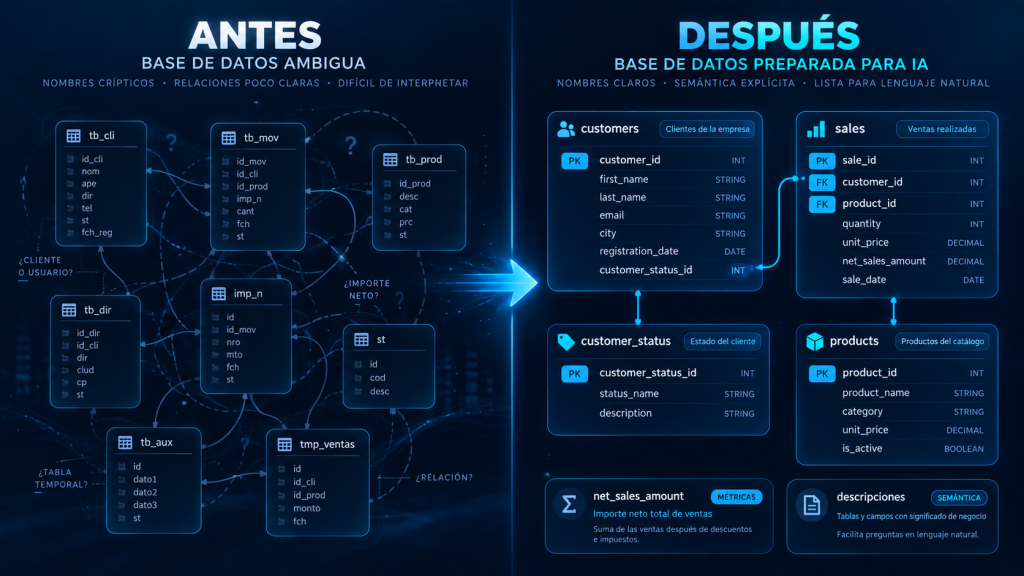
1. Utiliza nombres que expliquen el modelo de datos
Una de las mejoras más sencillas es también una de las más efectivas: utilizar nombres claros.
En lugar de:
tb_clipreferimos:
customersEn lugar de:
f_altapodemos utilizar:
customer_registration_dateY en lugar de:
imp_nalgo como:
net_sales_amountMicrosoft señala precisamente que la conversión de lenguaje natural a SQL depende de nombres expresivos en tablas y columnas. Si los nombres no describen suficientemente el dato, el asistente dispone de menos contexto para construir una consulta significativa.
Esto no significa escribir identificadores interminables. Significa priorizar claridad frente a abreviaturas que solo entiende el equipo que creó originalmente la aplicación.
2. Declara las relaciones en lugar de obligar al modelo a deducirlas
Las claves primarias y foráneas no son únicamente restricciones de integridad.
También son documentación estructurada.
Por ejemplo:
customers
---------
customer_id PK

orders
------
order_id PK
customer_id FK -> customers.customer_id
Para un asistente SQL, esta relación aporta una señal mucho más fiable que intentar inferir el JOIN únicamente comparando nombres de columnas.
El problema es especialmente importante en modelos grandes.
Supongamos que existen:
customers
orders
order_items
products
payments
shipments
sales_representatives
territories
Cuando un usuario pregunta: ¿Cuáles fueron las ventas por territorio?
pueden existir diferentes caminos para relacionar territorio y venta. Si el modelo tiene que elegirlos por intuición, aumenta la probabilidad de obtener una consulta sintácticamente correcta pero semánticamente equivocada.
Las capas semánticas modernas intentan resolver precisamente este problema definiendo de forma explícita las relaciones y rutas de unión. Snowflake, por ejemplo, incluye las relaciones entre entidades dentro de sus Semantic Views.
3. No expongas todo el modelo físico
Otro error habitual consiste en conectar el asistente directamente a cientos o miles de tablas operacionales. Más contexto no significa necesariamente mejor contexto.
Un ERP puede tener decenas de tablas relacionadas con clientes:
customers
customer_addresses
customer_contacts
customer_history
customer_status_history
customer_preferences
customer_segments
customer_import
customer_archive
Si la pregunta es “¿cuántos clientes activos tenemos?”, entregar todas esas tablas al modelo puede añadir ambigüedad en lugar de eliminarla.
Una estrategia más robusta consiste en construir una superficie de datos pensada para análisis.
Por ejemplo:
analytics.customers
analytics.sales
analytics.products
analytics.calendar
Estas vistas pueden ocultar complejidad técnica, normalizar nombres y presentar únicamente las columnas necesarias. Para sistemas de IA, una buena vista no es simplemente una comodidad para el analista, es una interfaz.
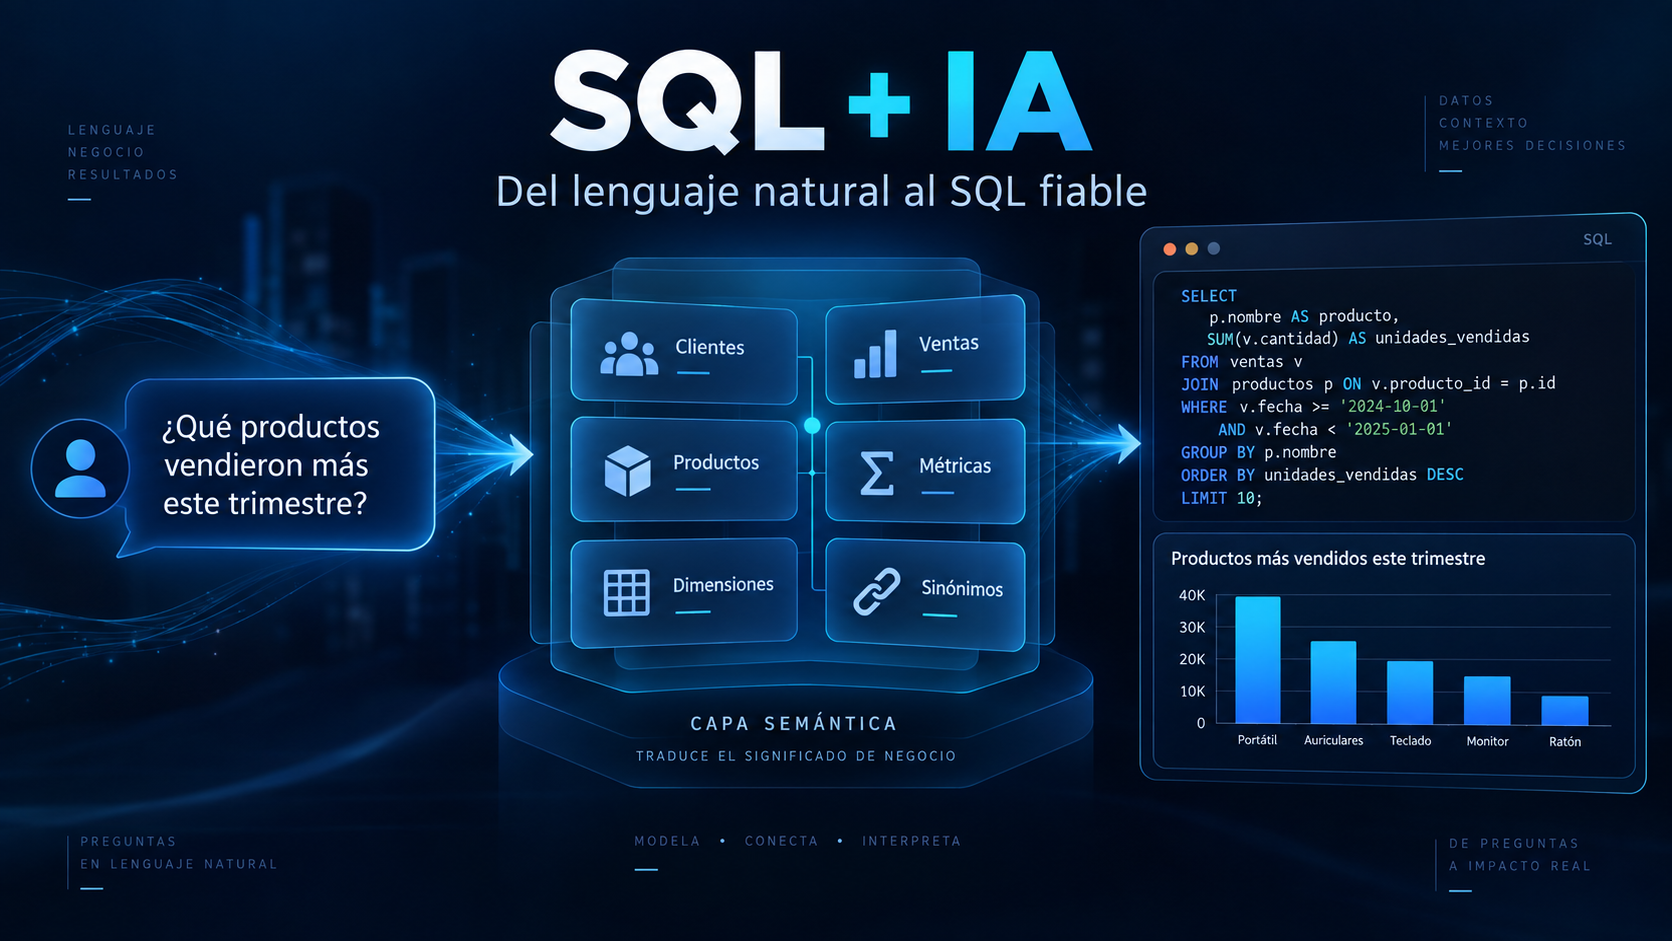
4. Construye una capa semántica
Aquí encontramos uno de los cambios más importantes que está produciendo la IA en los sistemas de datos. El esquema físico explica cómo se almacenan los datos.
La capa semántica explica qué significan.
Una organización puede definir, por ejemplo:
Métrica: ingresos netos
Definición: ventas brutas - descuentos - devoluciones
O:
Cliente activo:
cliente que ha realizado al menos una compra
durante los últimos 12 meses.
Sin esta definición, preguntas aparentemente simples pueden producir respuestas diferentes.
¿Qué significa “ventas”? ¿Importe facturado? ¿Cobrado? ¿Pedidos confirmados? ¿Importe sin IVA? ¿Importe después de devoluciones?
La IA no puede resolver correctamente estas ambigüedades si la organización nunca las ha formalizado.
Snowflake describe sus Semantic Views precisamente como una capa que representa entidades, dimensiones, hechos, métricas y relaciones utilizando conceptos de negocio. Además, recomienda este enfoque para nuevas implementaciones de análisis conversacional.
La capa semántica deja así de ser únicamente una herramienta de BI. Se convierte en infraestructura para IA.
5. Añade descripciones y sinónimos
Los usuarios no siempre utilizan el mismo vocabulario que la base de datos.
La tabla puede llamarse: sales_representatives
mientras que las personas preguntan por:
comerciales
vendedores
representantes
equipo de ventas
Una capa orientada a IA debería poder relacionar estos conceptos. Lo mismo ocurre con métricas. El usuario puede decir: facturación
mientras el modelo de datos habla de: net_revenue
Añadir descripciones, etiquetas y sinónimos reduce esa distancia entre lenguaje humano y modelo físico.
Este enriquecimiento de metadatos es uno de los motivos por los que las plataformas modernas están trasladando cada vez más información semántica al catálogo de datos.
6. Proporciona consultas SQL verificadas
Uno de los mecanismos más potentes para mejorar un sistema NL→SQL consiste en proporcionar pares de pregunta y SQL que sabemos que son correctos.
Por ejemplo:
Pregunta
¿Cuáles fueron los cinco productos con mayores
ingresos netos durante el último trimestre?
Consulta verificada
SELECT
    p.product_name,
    SUM(s.net_sales_amount) AS net_revenue
FROM analytics.sales AS s
JOIN analytics.products AS p
    ON s.product_id = p.product_id
WHERE s.sale_date >= DATE_TRUNC('quarter', CURRENT_DATE) - INTERVAL '3 months'
  AND s.sale_date < DATE_TRUNC('quarter', CURRENT_DATE)
GROUP BY p.product_name
ORDER BY net_revenue DESC
LIMIT 5;
Estos ejemplos cumplen dos funciones.
Primero, muestran al sistema cómo se traducen conceptos de negocio a estructuras SQL. Segundo, proporcionan casos conocidos contra los que podemos evaluar nuevas versiones.
Snowflake incorpora consultas verificadas como mecanismo para mejorar la confianza y también las utiliza como base para evaluar la precisión de Cortex Analyst.
Databricks sigue una filosofía similar mediante consultas SQL de ejemplo y activos confiables configurados dentro de Genie.
7. Trata la generación de SQL como un sistema que necesita pruebas
Cambiar el modelo, modificar una descripción o añadir una tabla puede alterar las consultas generadas. Por eso necesitamos pruebas de regresión. Podemos construir un conjunto de preguntas como:
¿Cuántos clientes activos tenemos?

¿Cuál fue el ingreso neto del mes pasado?

¿Qué categoría tiene mayor margen?

¿Cuáles son los diez clientes con más compras?

¿Cómo evolucionaron las ventas interanuales?
Para cada pregunta almacenamos una consulta o un resultado esperado. Después evaluamos cada nueva versión del sistema.
No es necesario exigir que el SQL generado sea idéntico carácter por carácter. Dos consultas diferentes pueden producir correctamente el mismo resultado.
Lo importante es validar aspectos como:
- tablas utilizadas;
- relaciones;
- filtros;
- métricas;
- agregaciones;
- periodo temporal;
- resultado final.
La evaluación continua convierte el NL→SQL en ingeniería y no simplemente en prompting.
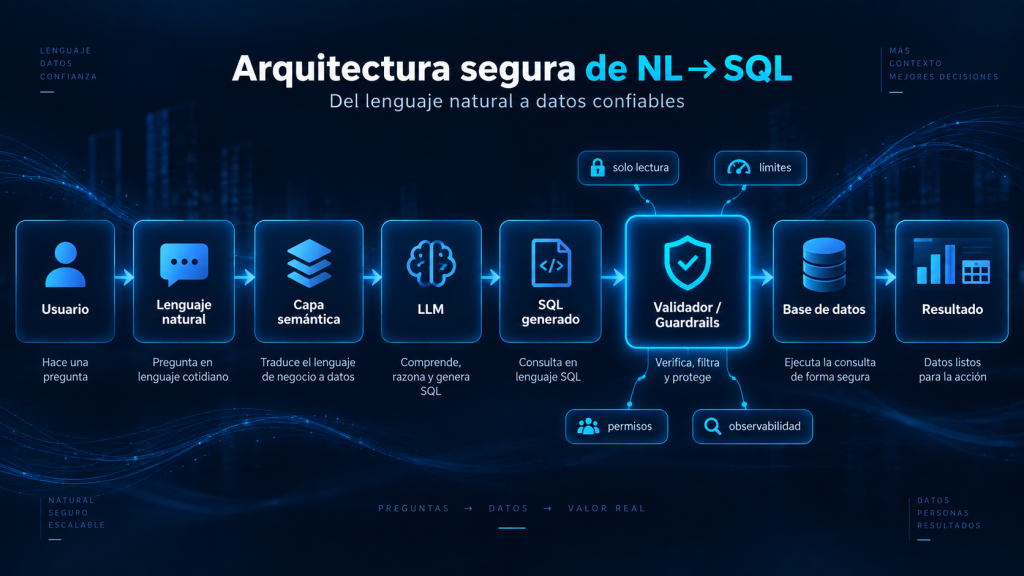
8. Introduce guardrails antes de ejecutar la consulta
Generar SQL y ejecutar SQL son dos problemas diferentes, aunque el sistema produzca una consulta válida, no deberíamos asumir automáticamente que es segura.
Una arquitectura sencilla puede funcionar así:
Pregunta del usuario
        ↓
Recuperación de contexto
        ↓
Generación SQL
        ↓
Validación
        ↓
Ejecución controlada
        ↓
Resultado
Entre generación y ejecución podemos introducir controles. Por ejemplo:
Solo lectura
El usuario destinado a análisis puede disponer únicamente de permisos SELECT.
De esta forma, incluso si el modelo genera accidentalmente:
DELETE FROM customers;la base de datos rechazará la operación.
Lista de objetos permitidos
El asistente puede consultar únicamente determinadas vistas analíticas.
Límites
Podemos imponer límites de filas o tiempo de ejecución.
Análisis previo
Antes de ejecutar podemos comprobar:
- presencia de
DELETE,UPDATE,DROPoALTER; - joins sin condiciones;
- consultas contra tablas prohibidas;
- estimaciones de coste excesivas.
Microsoft aplica una separación similar en sus experiencias Copilot: las respuestas generadas deben revisarse y las operaciones que pueden modificar datos requieren intervención o aprobación del usuario. La documentación también advierte expresamente de que las consultas generadas pueden ser inexactas.
9. Respeta los permisos del usuario
Un asistente no debería convertirse en una vía alternativa para saltarse el modelo de seguridad.
Si una persona no puede consultar salarios mediante SQL convencional, tampoco debería poder obtenerlos preguntando: ¿Cuál es el salario medio de cada empleado?
La ejecución debe realizarse con permisos equivalentes a los del usuario o mediante una política perfectamente controlada.
Databricks, por ejemplo, evalúa el acceso a los datos de Genie utilizando los permisos de Unity Catalog del usuario final.
El principio general es sencillo: la IA no sustituye el gobierno del dato; debe trabajar dentro de él.
10. Registra pregunta, SQL y resultado
Un sistema en producción necesita observabilidad. Como mínimo conviene registrar:
pregunta
contexto utilizado
SQL generado
tiempo de ejecución
error
usuario
feedback
Esto permite descubrir patrones. Quizá muchas consultas fallen cuando aparece la palabra “facturación”. Quizá una relación concreta produzca duplicados.
Quizá los usuarios utilicen un término que todavía no existe como sinónimo en la capa semántica.
Los errores dejan entonces de ser casos aislados y pasan a convertirse en información para mejorar el sistema.
Una arquitectura práctica
Una arquitectura razonable para un asistente SQL podría dividirse en cinco capas.
1. Datos físicos
Las tablas originales:
ERP
CRM
e-commerce
facturación
soporte
2. Modelo analítico
Vistas o tablas curadas:
customers
sales
products
calendar
3. Capa semántica
Aquí viven:
métricas
dimensiones
relaciones
definiciones
sinónimos
reglas de negocio
4. Sistema NL→SQL
El modelo recibe únicamente el contexto relevante y genera la consulta.
5. Validación y ejecución
Finalmente se aplican permisos, límites, comprobaciones y observabilidad.
La arquitectura sería:
Usuario
   ↓
Lenguaje natural
   ↓
Contexto + capa semántica
   ↓
LLM / agente SQL
   ↓
SQL generado
   ↓
Validador
   ↓
Motor SQL
   ↓
Resultado
La mayor parte de la fiabilidad no procede exclusivamente de la caja “LLM”. Procede de todo lo que la rodea.
Checklist para preparar SQL para IA
Antes de conectar un asistente de lenguaje natural a una base de datos, merece la pena revisar:
- ¿Las tablas tienen nombres comprensibles?
- ¿Las columnas expresan claramente qué representan?
- ¿Las claves primarias y foráneas están declaradas?
- ¿Las relaciones importantes están documentadas?
- ¿Las métricas de negocio tienen una única definición?
- ¿Existen vistas analíticas que oculten complejidad innecesaria?
- ¿Se han definido sinónimos del vocabulario utilizado por los usuarios?
- ¿Tenemos preguntas y consultas verificadas?
- ¿Existe un conjunto de pruebas de regresión?
- ¿El usuario de ejecución tiene permisos mínimos?
- ¿Las consultas generadas pasan por un validador?
- ¿Registramos errores y feedback?
Cuantas más respuestas sean afirmativas, menos dependerá el sistema de que el modelo “adivine”.
Conclusión
La llegada de la IA está obligándonos a mirar las bases de datos desde una perspectiva nueva. Durante años optimizamos esquemas para aplicaciones, desarrolladores y herramientas de BI.
Ahora tenemos un nuevo consumidor: los modelos de lenguaje. Y estos modelos funcionan mejor cuando el significado está explícito.
Un esquema limpio ayuda, las relaciones ayudan, las vistas ayudan.
Pero el verdadero salto aparece cuando añadimos una capa semántica con métricas, conceptos, sinónimos y ejemplos verificados, y posteriormente rodeamos la generación SQL de permisos, validación y evaluación.
Por eso, antes de buscar un modelo más grande para mejorar tu sistema NL→SQL, merece la pena hacer una pregunta diferente:
¿Entendería alguien nuevo en tu equipo lo que significa tu modelo de datos sin tener que preguntarte nada?
Si la respuesta es no, probablemente la IA tampoco.
REFERENCIAS
- Snowflake — Cortex Analyst y Semantic Views.
- Snowflake — buenas prácticas y evaluación mediante consultas verificadas.
- Snowflake — instrucciones personalizadas para generación SQL, incorporadas a Semantic Views durante 2026.
- Databricks — Genie Agents, Unity Catalog, instrucciones, consultas de ejemplo y trusted assets.
- Google Cloud — BigQuery Data Canvas y uso de metadatos de catálogo para consultas en lenguaje natural.
- Microsoft — Copilot para SQL Database en Fabric, recomendaciones sobre nombres descriptivos, permisos y validación humana.