Bases de datos temporales: cómo modelar el pasado, el presente y la vigencia sin perder información
- dmoreno
- octubre 7, 2026
- Bases de datos
- bases de datos, BBDD, modelado, series temporales, software
- 0 Comments
La mayoría de las bases de datos responden muy bien a una pregunta: ¿cuál es el valor actual?
El problema empieza cuando necesitamos preguntar algo diferente:
¿Qué precio tenía este producto el 15 de marzo?
¿Qué dirección constaba para este cliente cuando se emitió una factura?
¿Desde cuándo estaba vigente una determinada tarifa?
¿Qué datos conocía realmente el sistema antes de que alguien corrigiera un error?
¿Existieron dos contratos incompatibles vigentes al mismo tiempo?
En una tabla convencional, un UPDATE sustituye un valor por otro. Si ayer un precio era 100 y hoy pasa a 120, normalmente la fila termina conteniendo únicamente 120. El presente queda perfectamente representado, el pasado desaparece.
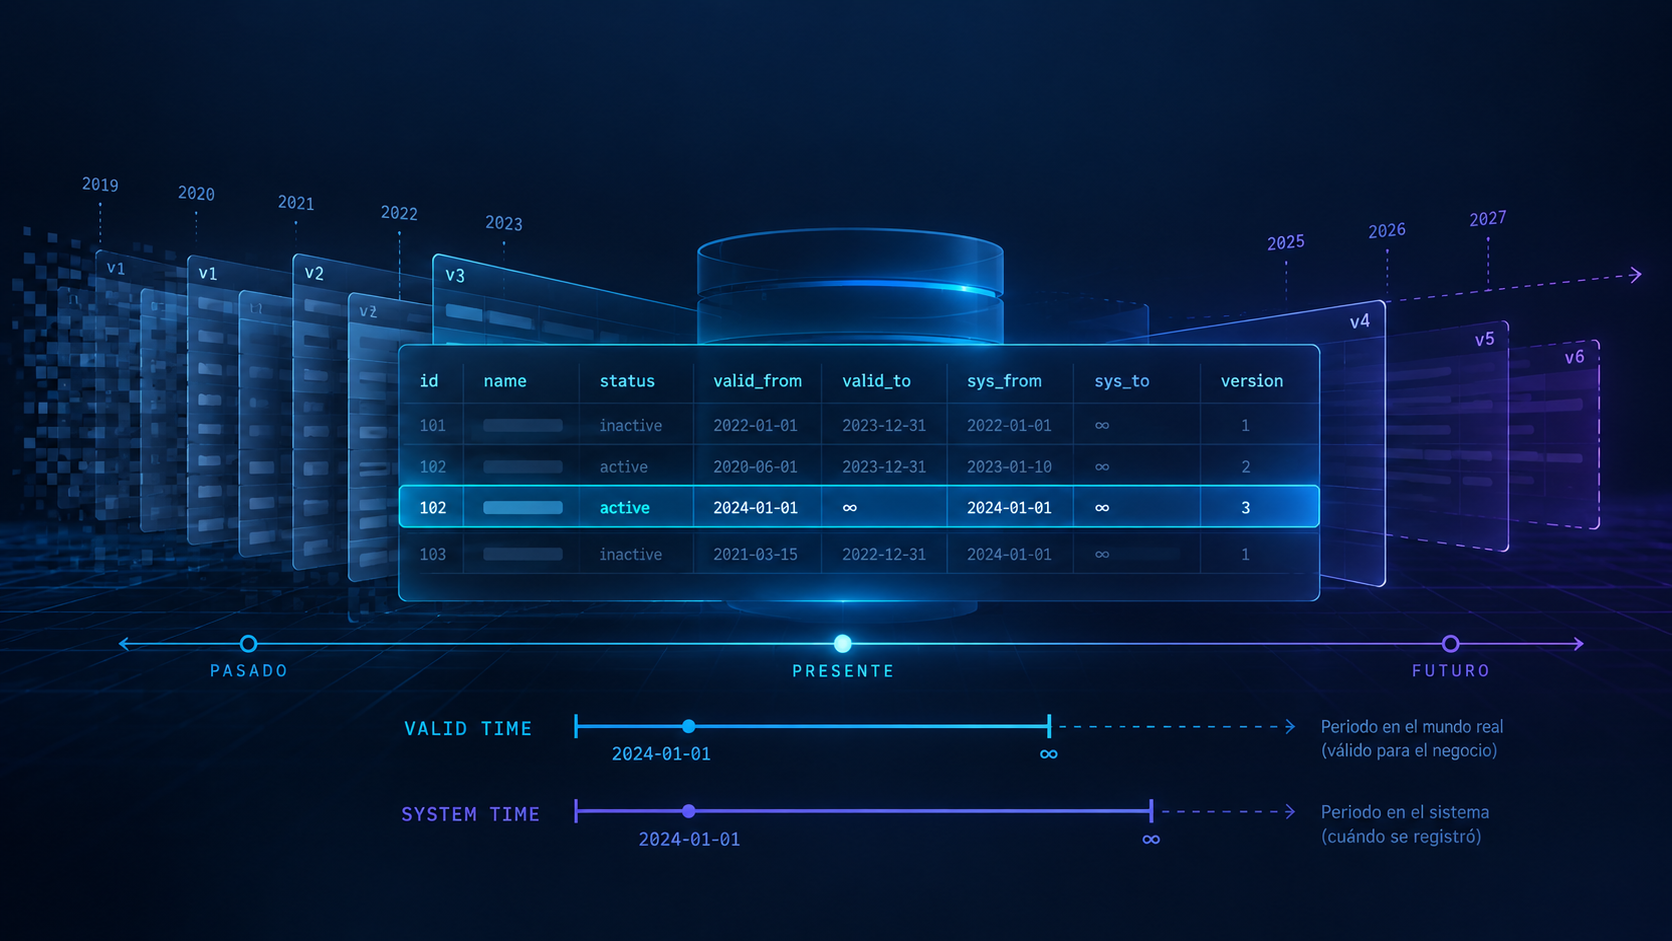
Ahí entra en juego el modelado temporal. Una base de datos temporal no se limita a almacenar hechos, también representa cuándo son o fueron válidos esos hechos y, en algunos modelos, cuándo llegaron a conocimiento del sistema.
Esa distinción parece pequeña, pero cambia profundamente la forma de diseñar tablas, claves, relaciones, auditorías y consultas históricas.
Dos preguntas distintas sobre el tiempo
Antes de crear columnas fecha_desde y fecha_hasta, conviene aclarar qué significa exactamente el tiempo dentro del modelo.
Hay dos dimensiones especialmente importantes.
1. Tiempo de validez o tiempo de negocio
Representa cuándo es cierto un dato en el mundo que estamos modelando.
Imaginemos una tarifa:
| tarifa | precio | válida desde | válida hasta |
|---|---|---|---|
| Premium | 49 € | 2026-01-01 | 2026-04-01 |
| Premium | 55 € | 2026-04-01 | 2026-09-01 |
| Premium | 59 € | 2026-09-01 | ∞ |
La pregunta que resuelve esta dimensión es: ¿Qué valor era válido en una fecha determinada?
No importa cuándo se introdujo la información en la base de datos, importa cuándo debía aplicarse desde el punto de vista del negocio.
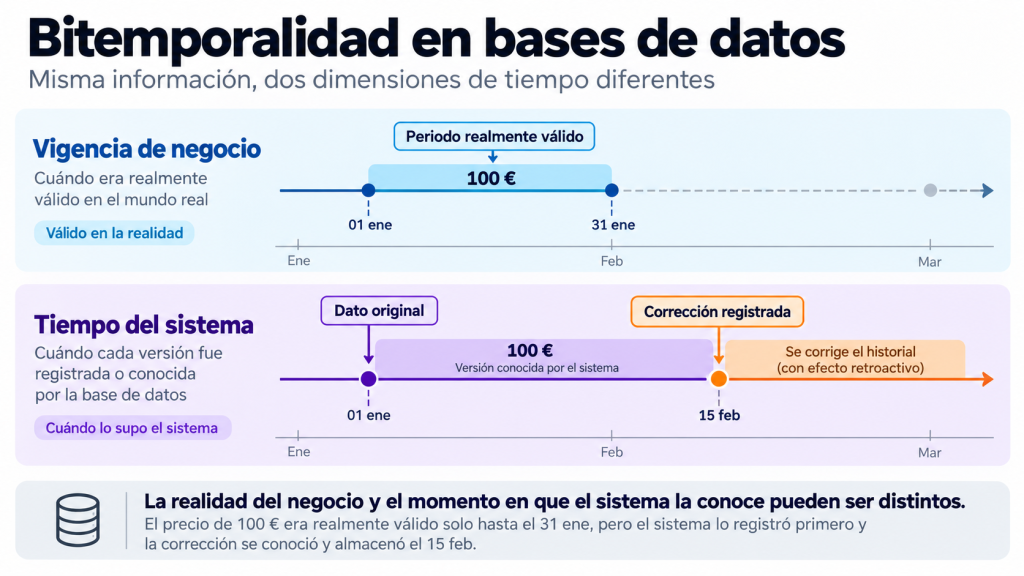
2. Tiempo del sistema o tiempo de transacción
Representa durante qué periodo una determinada versión estuvo registrada en la base de datos.
Supongamos que el 10 de octubre descubrimos que una tarifa que habíamos registrado con fecha de inicio 1 de septiembre debía haber comenzado realmente el 15 de agosto. Desde la perspectiva del negocio, corregimos la fecha de vigencia, pero desde la perspectiva de auditoría también puede interesarnos saber que:
hasta el 10 de octubre el sistema almacenaba una versión;
a partir del 10 de octubre almacenó la versión corregida.
La pregunta pasa a ser: ¿Qué sabía el sistema en un momento concreto?
SQL Server denomina a este enfoque system-versioned temporal tables y mantiene automáticamente las versiones anteriores de las filas en una tabla histórica.
Cuando necesitamos ambas dimensiones: modelos bitemporales
Los problemas más interesantes aparecen cuando necesitamos conservar simultáneamente:
cuándo era válido un dato en negocio;
cuándo fue conocido o registrado por el sistema.
Eso produce un modelo bitemporal.
Pensemos en una póliza de seguro, la compañía registra el 5 de mayo que una cobertura comienza el 1 de mayo. El 20 de mayo recibe documentación que demuestra que la cobertura realmente comenzó el 28 de abril. La nueva información cambia el periodo válido de negocio, pero no debería borrar el hecho de que, entre el 5 y el 20 de mayo, el sistema creía otra cosa.
Con dos dimensiones temporales podemos responder tanto: ¿Qué cobertura correspondía al cliente el 30 de abril?
como: ¿Qué pensábamos el 10 de mayo que correspondía al cliente el 30 de abril?
Son consultas completamente distintas. Y esa diferencia es fundamental en ámbitos como finanzas, seguros, facturación, recursos humanos, contratos, inventario, regulación o sistemas donde una corrección retrospectiva no debería reescribir silenciosamente la historia.
El patrón clásico: intervalos de vigencia
Cuando el motor no gestiona automáticamente el tiempo de negocio, un patrón habitual consiste en representar cada versión mediante un intervalo.
Por ejemplo:
CREATE TABLE precio_producto (
    producto_id   BIGINT        NOT NULL,
    precio        DECIMAL(10,2) NOT NULL,
    valido_desde  TIMESTAMP     NOT NULL,
    valido_hasta  TIMESTAMP,
    PRIMARY KEY (producto_id, valido_desde)
);
Cada fila deja de representar simplemente «el precio del producto».
Representa: «Este precio fue válido para este producto durante este intervalo.»
La diferencia conceptual es importante.
¿Intervalos cerrados o semiabiertos?
Una de las decisiones más sencillas y más importantes del diseño temporal consiste en definir qué significan los extremos.
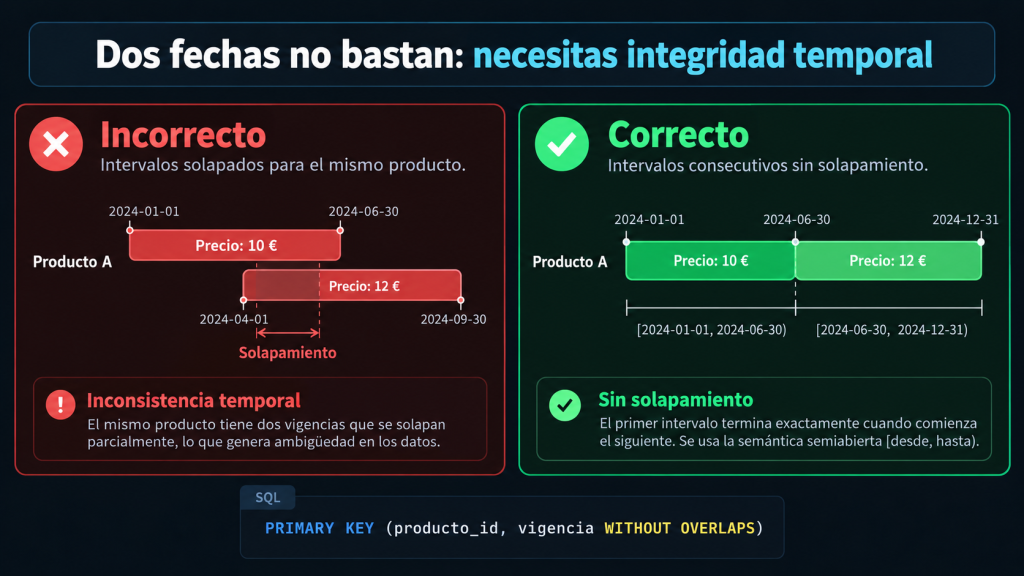
Una convención particularmente útil es utilizar intervalos semiabiertos:
[desde, hasta)Es decir:
desdeestá incluido;hastaestá excluido.
Así podemos representar dos periodos consecutivos:
[2026-01-01, 2026-04-01)
[2026-04-01, 2026-09-01)
sin crear ambigüedad sobre cuál de las dos versiones está vigente exactamente el 1 de abril.
Una consulta conceptual sería:
SELECT *
FROM precio_producto
WHERE producto_id = 42
  AND valido_desde <= TIMESTAMP '2026-04-15 12:00:00'
  AND (
        valido_hasta > TIMESTAMP '2026-04-15 12:00:00'
        OR valido_hasta IS NULL
      );
La regla importante no es únicamente escribir correctamente esta consulta, es utilizar la misma semántica temporal en todo el sistema.
El problema que dos columnas no solucionan: los solapamientos
Añadir valido_desde y valido_hasta no convierte mágicamente una tabla en un modelo temporal correcto.
Imaginemos estas filas:
Producto 42 — 100 € — [01 enero, 01 junio)
Producto 42 — 120 € — [01 mayo, 01 septiembre)
Durante mayo existen dos precios simultáneamente. Si el dominio permite solamente un precio por producto, el modelo ha violado una regla de negocio.
La aplicación puede intentar evitarlo, pero cuanto más crítica sea la integridad, más interesante resulta que sea la propia base de datos la que impida estados imposibles.
PostgreSQL 18 y las restricciones temporales
Aquí aparece una evolución especialmente relevante. PostgreSQL 18 incorporó soporte para restricciones temporales mediante WITHOUT OVERLAPS en claves primarias y restricciones UNIQUE, además de claves foráneas temporales mediante PERIOD.
Podemos modelar un periodo utilizando un rango:
CREATE TABLE precio_producto (
    producto_id BIGINT NOT NULL,
    precio      NUMERIC(10,2) NOT NULL,
    vigencia    tstzrange NOT NULL,
    PRIMARY KEY (producto_id, vigencia WITHOUT OVERLAPS)
);
El objetivo de WITHOUT OVERLAPS es precisamente impedir que dos filas con la misma parte no temporal de la clave tengan periodos que se solapen.
Conceptualmente:
Producto 42 + [enero, abril)   ✓
Producto 42 + [abril, junio)   ✓
Producto 42 + [marzo, mayo)    ✗
PostgreSQL implementa esta semántica aprovechando sus tipos range y mecanismos de exclusión. La documentación actual explica que la última columna de una clave con WITHOUT OVERLAPS debe ser un rango o multirango.
Esto tiene una consecuencia arquitectónica interesante: la integridad temporal puede dejar de ser exclusivamente responsabilidad de la aplicación.
Relaciones que también dependen del tiempo
Evitar solapamientos dentro de una tabla es solamente la mitad del problema.
Supongamos que tenemos contratos asociados a una tarifa, no basta con comprobar que la tarifa existe, necesitamos garantizar que existe durante todo el periodo del contrato.
PostgreSQL 18 permite utilizar PERIOD en determinadas claves foráneas temporales. La referencia se considera válida cuando las filas correspondientes de la tabla referenciada cubren conjuntamente todo el periodo que queremos referenciar.
Esta idea resuelve un problema que tradicionalmente exigía triggers, lógica de aplicación o consultas adicionales: no solo necesito saber si la entidad referenciada existe, sino si existe durante el intervalo necesario.
En sistemas complejos, esta diferencia resulta enorme.
SQL Server: versionado automático del historial
SQL Server aborda otra dimensión del problema temporal de forma especialmente integrada. Una tabla temporal versionada por el sistema utiliza dos columnas de periodo y una tabla histórica asociada.
Un ejemplo simplificado sería:
CREATE TABLE dbo.Cliente
(
    ClienteId INT NOT NULL PRIMARY KEY,
    Nombre NVARCHAR(200) NOT NULL,
    Ciudad NVARCHAR(100),
    ValidFrom DATETIME2 GENERATED ALWAYS AS ROW START NOT NULL,
    ValidTo DATETIME2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (ValidFrom, ValidTo)
)
WITH (
    SYSTEM_VERSIONING = ON
);
A partir de ahí, las operaciones normales de modificación continúan realizándose sobre la tabla actual. Cuando una fila cambia o se elimina, SQL Server conserva automáticamente la versión anterior en una tabla histórica asociada.
Eso evita tener que implementar manualmente gran parte de la infraestructura de auditoría histórica.
Consultar el pasado con FOR SYSTEM_TIME
Una de las ventajas más visibles aparece al reconstruir estados históricos.
Por ejemplo:
SELECT *
FROM dbo.Cliente
FOR SYSTEM_TIME AS OF '2026-03-01T10:00:00'
WHERE ClienteId = 42;
La consulta pide: muéstrame la versión del cliente 42 que el sistema consideraba vigente en ese instante.
SQL Server dispone además de variantes para consultar intervalos o todo el historial mediante opciones como FROM ... TO, BETWEEN, CONTAINED IN y ALL.
Para análisis forense, auditoría y reconstrucción de estados, esa capacidad simplifica muchísimo consultas que de otro modo tendrían que combinar manualmente tablas actuales e históricas.
MariaDB: tiempo del sistema y tiempo de aplicación
MariaDB también ofrece capacidades temporales que permiten diferenciar entre versionado del sistema y periodos definidos desde la lógica de negocio.
Los periodos de aplicación permiten definir columnas de inicio y fin mediante PERIOD, mientras cláusulas como FOR PORTION OF permiten operar sobre partes concretas del periodo.
Un esquema conceptual sería:
CREATE TABLE contrato (
    contrato_id INT,
    descripcion VARCHAR(200),
    valido_desde DATE,
    valido_hasta DATE,
    PERIOD FOR vigencia (valido_desde, valido_hasta)
);
La diferencia frente a guardar dos fechas arbitrarias está en que el motor empieza a comprender que esas columnas forman conjuntamente un periodo temporal con semántica propia.
Oracle y Flashback
Oracle aborda parte del problema desde sus tecnologías Flashback.
Flashback Data Archive permite conservar automáticamente datos históricos y asociar políticas de retención, de forma que versiones anteriores puedan consultarse mediante mecanismos de Flashback Query.
De nuevo aparece una idea recurrente: el historial no debería considerarse simplemente una copia secundaria de datos antiguos. Puede convertirse en una dimensión consultable del modelo.
Temporalidad no es lo mismo que auditoría
Es fácil confundir varios conceptos. Una tabla de auditoría podría registrar algo parecido a:
usuario: david
acción: UPDATE
tabla: cliente
fecha: 2026-10-05 17:20
Eso puede ser suficiente para saber quién hizo qué. Pero no necesariamente permite reconstruir correctamente:
el estado completo de una entidad;
su periodo de validez;
todas sus relaciones históricas;
qué datos estaban vigentes en un instante.
La auditoría responde principalmente a preguntas sobre acciones, el modelado temporal responde a preguntas sobre estados y periodos. Pueden complementarse, pero no son equivalentes.
Tampoco es lo mismo que un Slowly Changing Dimension
En Business Intelligence es habitual utilizar dimensiones lentamente cambiantes, especialmente el patrón SCD Tipo 2.
Por ejemplo:
cliente_id | ciudad     | desde      | hasta
-----------|------------|------------|------------
10         | Madrid     | 2024-01-01 | 2025-06-10
10         | Pamplona   | 2025-06-10 | NULL
El patrón tiene mucho en común con el modelado temporal porque conserva diferentes versiones de una entidad. Pero una arquitectura analítica y un modelo operacional tienen objetivos distintos.
En un data warehouse solemos priorizar:
análisis histórico;
cargas ETL/ELT;
dimensiones y hechos;
reproducibilidad de informes.
En sistemas transaccionales necesitamos además pensar en:
concurrencia;
integridad;
modificaciones retroactivas;
relaciones temporales;
reglas de negocio;
coste de almacenamiento;
políticas de retención.
Por eso copiar mecánicamente un patrón SCD a una aplicación operacional no siempre es suficiente.
La pregunta incómoda: ¿cuánto historial vamos a conservar?
Guardar la historia tiene un coste. En SQL Server, cada modificación o eliminación de una fila versionada puede generar datos históricos. Microsoft recomienda definir explícitamente una estrategia de retención porque tablas históricas con mucha actividad y largos periodos de conservación pueden crecer de forma importante y terminar afectando tanto al almacenamiento como al rendimiento de consultas temporales.
Antes de habilitar temporalidad conviene responder:
¿Durante cuánto tiempo necesitamos consultar el histórico online?
¿Existe una obligación legal de conservarlo?
¿Puede archivarse parte del historial?
¿Qué frecuencia de actualización tendrá la tabla?
¿Qué índices necesitan las consultas históricas?
¿Cuánto crecerá la tabla en uno, tres y cinco años?
Una política temporal sin política de retención suele convertirse tarde o temprano en un problema de operaciones.
No todos los datos necesitan temporalidad
Guardar historia porque «puede resultar útil» no siempre justifica la complejidad. La temporalidad tiene especial sentido cuando el pasado tiene valor operativo, contractual, analítico o regulatorio.
Ejemplos claros:
precios;
contratos;
pólizas;
salarios;
jerarquías organizativas;
permisos;
configuraciones;
datos maestros;
asignaciones;
estados regulatorios;
atributos que afectan a facturación;
relaciones cuya vigencia necesita demostrarse.
En cambio, para determinados datos efímeros o fácilmente regenerables, conservar todas sus versiones puede ofrecer poco valor.
Cinco reglas prácticas para diseñar datos temporales
1. Define qué reloj estás modelando
¿Representas tiempo de negocio, tiempo del sistema o ambos?
Nunca utilices una columna llamada simplemente fecha si su significado temporal es importante.
2. Documenta la semántica de los extremos
Decide explícitamente si tus intervalos son:
[desde, hasta)o utilizan otra convención. No dejes esa interpretación en manos de cada desarrollador.
3. Impide solapamientos cuando el dominio no los permita
Una regla crítica de integridad debería estar, siempre que sea posible, lo más cerca posible de los datos.
Las restricciones temporales disponibles en motores modernos pueden reducir mucha lógica defensiva en la aplicación.
4. Diseña también las relaciones temporales
No basta con versionar entidades individualmente.
Pregunta: ¿La relación entre estas entidades también tiene una vigencia?
Un empleado puede pertenecer a distintos departamentos a lo largo del tiempo. Un producto puede pertenecer a diferentes categorías. Una persona puede tener diferentes permisos.
Muchas veces la relación es tan temporal como la entidad.
5. Diseña la eliminación del historial antes de acumularlo
Retención, particionado, archivado e índices deberían formar parte del diseño inicial.
No esperes a que una tabla histórica tenga cientos de millones de filas para preguntarte cuánto tiempo era necesario conservarlas.
Qué motor elegir
No existe una única estrategia universal.
SQL Server resulta especialmente cómodo cuando necesitas versionado automático del estado almacenado y consultas históricas integradas mediante FOR SYSTEM_TIME.
PostgreSQL 18 da un salto importante en integridad temporal al incorporar claves con WITHOUT OVERLAPS y relaciones temporales mediante PERIOD.
MariaDB permite trabajar tanto con versionado del sistema como con periodos de aplicación.
Oracle dispone de mecanismos Flashback orientados a reconstrucción y conservación histórica.
La elección no debería basarse únicamente en cuál posee más sintaxis temporal.
Lo importante es saber qué problema necesitas resolver:
auditoría;
vigencia de negocio;
reconstrucción histórica;
correcciones retroactivas;
integridad de intervalos;
relaciones temporales;
análisis bitemporal.
Conclusión
Los datos cambian, nuestros modelos deberían reconocerlo. Cuando actualizamos una fila convencional estamos tomando una decisión implícita: el valor anterior deja de importarnos.
En muchos dominios esa suposición es falsa. El pasado puede determinar una factura, explicar una decisión, reconstruir un incidente, validar un contrato o responder una auditoría.
Modelar correctamente el tiempo no consiste en añadir dos columnas de fecha, significa decidir:
qué representa cada reloj;
qué periodos son válidos;
si pueden solaparse;
cómo se relacionan temporalmente las entidades;
qué historia queremos conservar;
y durante cuánto tiempo.
La buena noticia es que los motores relacionales están incorporando cada vez más de estas reglas como capacidades nativas.
Y cuanto mejor entienda la base de datos la semántica temporal, menos dependeremos de código accidental para recordar correctamente nuestro propio pasado.
REFERENCIAS
- Microsoft Learn — Temporal tables (SQL Server), documentación actualizada en 2026: https://learn.microsoft.com/en-us/sql/relational-databases/tables/temporal-tables?view=sql-server-ver17
- Microsoft Learn — Create a System-Versioned Temporal Table, actualizado el 18/08/2026: https://learn.microsoft.com/en-us/sql/relational-databases/tables/creating-a-system-versioned-temporal-table?view=sql-server-ver17
- Microsoft Learn — Query Data in a System-Versioned Temporal Table: https://learn.microsoft.com/en-us/sql/relational-databases/tables/temporal/query-data?view=sql-server-ver15
- Microsoft Learn — Manage Historical Data in System-Versioned Temporal Tables: https://learn.microsoft.com/en-us/sql/relational-databases/tables/manage-retention-of-historical-data-in-system-versioned-temporal-tables?view=sql-server-ver17
- PostgreSQL 18 — Release notes: temporal constraints with WITHOUT OVERLAPS and PERIOD: https://www.postgresql.org/docs/18/release-18.html
- PostgreSQL 18 — CREATE TABLE, temporal keys and PERIOD foreign keys: https://www.postgresql.org/docs/18/sql-createtable.html
- MariaDB — Rewinding Time in MariaDB Databases: System-Versioning and Application-Time: https://mariadb.com/resources/blog/rewinding-time-in-mariadb-databases-system-versioning-and-application-time/
- Oracle Database — CREATE FLASHBACK ARCHIVE: https://docs.oracle.com/en/database/oracle/oracle-database/18/sqlrf/CREATE-FLASHBACK-ARCHIVE.html