RAG, búsqueda semántica o contexto directo: cómo elegir la arquitectura adecuada para una aplicación con IA
- dmoreno
- septiembre 1, 2026
- Arquitectura de software
- Arquitectura, Automatización, ia, InteligenciaArtificial, RAG, software
- 0 Comments
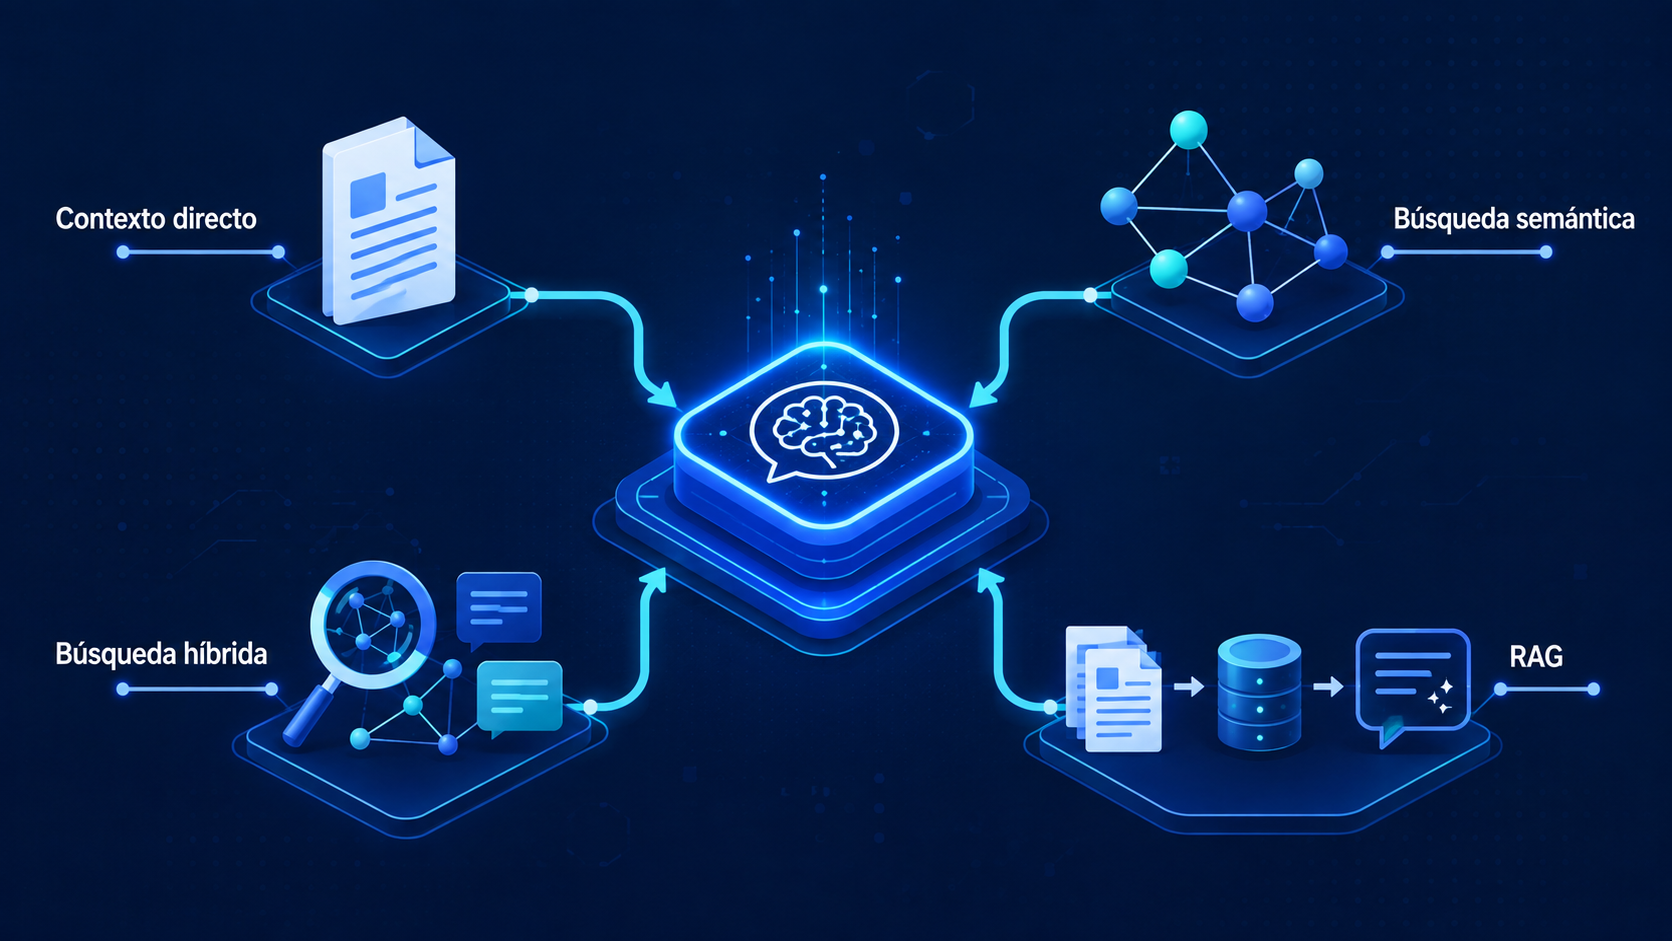
El patrón más sencillo consiste en proporcionar al modelo toda la información necesaria junto con la petición. No hay índice vectorial, chunking ni pipeline de recuperación.
Imaginemos una aplicación que analiza el manual interno de un equipo, un contrato concreto o el código de un repositorio pequeño. Si el contenido cabe en el contexto aceptado por el modelo y el coste es razonable, introducir una infraestructura RAG completa puede aportar más complejidad que valor.
Las ventanas de contexto actuales pueden ser enormes. Google documenta modelos Gemini con ventanas de un millón de tokens o más y plantea explícitamente el contexto largo como alternativa viable para determinados problemas que anteriormente requerían RAG. También advierte de que enviar más información tiene implicaciones de coste y latencia y que la recuperación sobre contextos muy grandes no es perfecta en todos los escenarios.
Cuándo tiene sentido
El contexto directo encaja especialmente bien cuando:
- El corpus es pequeño o mediano.
- Cambia poco.
- Cada consulta necesita buena parte de los documentos.
- Quieres reducir componentes de infraestructura.
- El número de consultas no hace prohibitivo reenviar el mismo contenido.
La caché de contexto puede cambiar todavía más esta ecuación cuando muchas peticiones reutilizan un prefijo grande de información. La documentación actual de Gemini, por ejemplo, contempla caching explícito e implícito para reducir el coste asociado a esos patrones.
Su principal limitación
Que algo quepa en la ventana de contexto no significa que debamos enviarlo siempre. Más tokens implican más datos que procesar y normalmente más tiempo hasta obtener la respuesta. Además, en problemas con múltiples piezas concretas de información escondidas en un contexto enorme, la precisión puede degradarse. Por eso el tamaño máximo de contexto no debería convertirse en un objetivo de arquitectura.
La pregunta correcta no es cuánto contexto admite el modelo, sino cuánto contexto necesita realmente para responder.
Opción 2: búsqueda semántica
La búsqueda semántica intenta recuperar contenido por significado y no únicamente mediante coincidencias literales.
Para ello, normalmente convertimos documentos y consultas en embeddings: representaciones vectoriales que permiten calcular qué fragmentos están semánticamente próximos.
Supongamos que un usuario pregunta:
«¿Qué ocurre si un empleado deja la empresa?»
El documento quizá no contiene esa frase. Puede hablar de «procedimiento de baja», «revocación de credenciales» o «offboarding».
Una búsqueda literal podría perder información relevante. Una búsqueda basada en embeddings tiene más posibilidades de relacionar ambos conceptos.
Cuándo funciona bien
La búsqueda semántica es atractiva cuando:
- Los usuarios formulan preguntas con vocabulario diferente al de los documentos.
- Queremos descubrir contenido conceptualmente similar.
- Existen grandes cantidades de texto no estructurado.
- No necesitamos generar siempre una respuesta: quizá solo queremos devolver documentos relevantes.
Este último punto es importante.
Una búsqueda vectorial no es RAG por sí misma.
Puedes usar embeddings para un buscador interno, recomendaciones o detección de similitud sin que intervenga ningún LLM generativo.
El problema de utilizar solo vectores
El significado no lo es todo.
Hay consultas donde una coincidencia exacta importa mucho:
ERR_CONNECTION_RESET;SKU-28491;Factura 2026-00381;- nombres propios;
- versiones;
- fechas;
- referencias legales.
Microsoft destaca precisamente esta diferencia: la búsqueda vectorial funciona bien para similitud conceptual, mientras que la búsqueda textual mantiene ventajas para coincidencias exactas y terminología especializada.
Eso nos lleva a una arquitectura cada vez más habitual.
Opción 3: búsqueda híbrida
La búsqueda híbrida ejecuta dos estrategias a la vez:
- búsqueda textual o keyword
- búsqueda vectorial.
Después combina sus resultados.
Azure AI Search, por ejemplo, ejecuta ambas consultas en paralelo y fusiona sus rankings mediante Reciprocal Rank Fusion RRF, para obtener un único conjunto ordenado de resultados. También permite añadir reranking semántico posteriormente.
Este enfoque resuelve una debilidad frecuente de los sistemas puramente vectoriales.
Pensemos en:
«¿Qué cambios afectan al endpoint
/v2/ordersen la versión 4.3?»
La similitud semántica puede localizar documentación relacionada con pedidos y APIs.
La búsqueda textual puede garantizar que aparezcan resultados que contienen exactamente /v2/orders y 4.3.
La combinación suele proporcionar una recuperación más robusta.
Una regla práctica
Cuando tus datos contienen una mezcla de lenguaje natural y elementos que deben coincidir exactamente (códigos, nombres, números, fechas o identificadores), evalúa búsqueda híbrida antes de apostar exclusivamente por vectores.
No significa que siempre gane. Significa que deberías medirla.
Opción 4: RAG
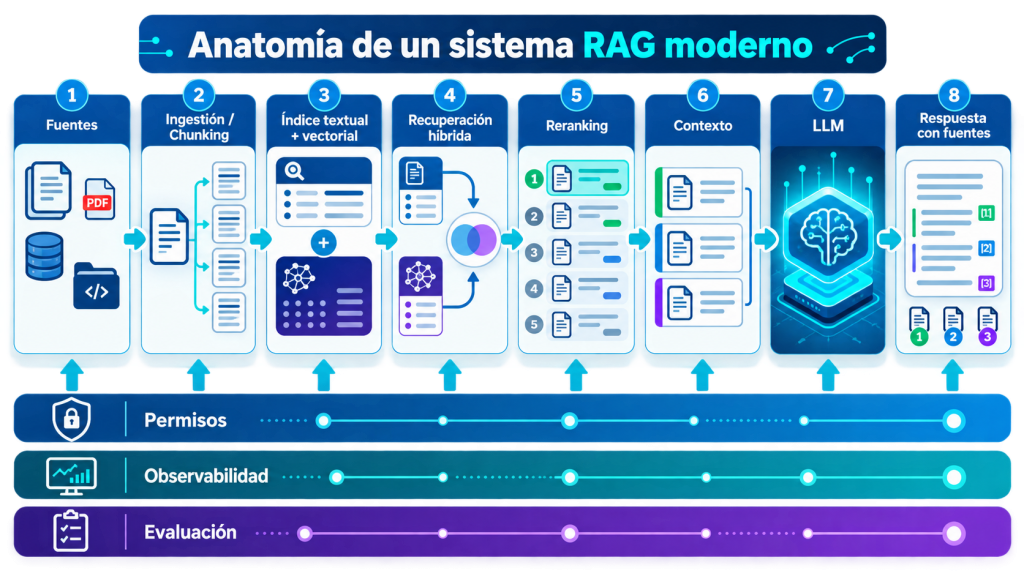
RAG empieza a aportar todo su valor cuando la información disponible supera lo que tiene sentido enviar directamente al modelo y debemos seleccionar dinámicamente qué contexto utilizar.
Un pipeline habitual puede parecerse a esto:
fuentes → ingestión → chunking → índices → recuperación → reranking → construcción del contexto → LLM → respuesta
La ventaja fundamental es la escalabilidad. El modelo no tiene que recibir toda la base documental. Solo recibe una selección de evidencia potencialmente relevante.
Anthropic describe el mismo principio al explicar que RAG permite escalar a bases de conocimiento que exceden la ventana de contexto: el sistema recupera solamente fragmentos relevantes y los incorpora a la petición.
Pero cada etapa añade decisiones nuevas.
Chunking
¿Cómo dividir documentos?
Un fragmento demasiado pequeño puede perder contexto. Uno demasiado grande incorpora ruido y consume más tokens.
Anthropic ha mostrado precisamente cómo los chunks aislados pueden perder información esencial, por ejemplo, a qué empresa o periodo pertenece una cifra, y propone añadir contexto específico a cada fragmento antes de indexarlo mediante su enfoque de Contextual Retrieval.
Recuperación
¿Cuántos resultados recuperamos?
Recuperar poco puede dejar fuera la respuesta correcta. Recuperar demasiado introduce ruido y aumenta el contexto enviado.
Reranking
Una primera búsqueda puede generar candidatos rápidamente. Un reranker posterior puede volver a ordenarlos utilizando una evaluación semántica más potente.
Filtros y seguridad
En aplicaciones empresariales, relevancia no equivale a autorización. Un documento puede ser perfecto para responder una pregunta y, aun así, el usuario no debería poder verlo. Por eso permisos, tenant, departamento, región, versión o clasificación del documento deben formar parte del diseño de recuperación y no añadirse como parche después.
Observabilidad
Un sistema RAG necesita responder preguntas que una llamada sencilla a un LLM no plantea:
- ¿se recuperó el documento correcto?
- ¿el problema fue retrieval o generación?
- ¿qué chunks llegaron al modelo?
- ¿qué puntuación tenían?
- ¿qué versión del documento se utilizó?
- ¿el modelo respondió utilizando realmente la evidencia recuperada?
Sin esa observabilidad, optimizar RAG se convierte rápidamente en ensayo y error.
Entonces, ¿qué arquitectura elegir?
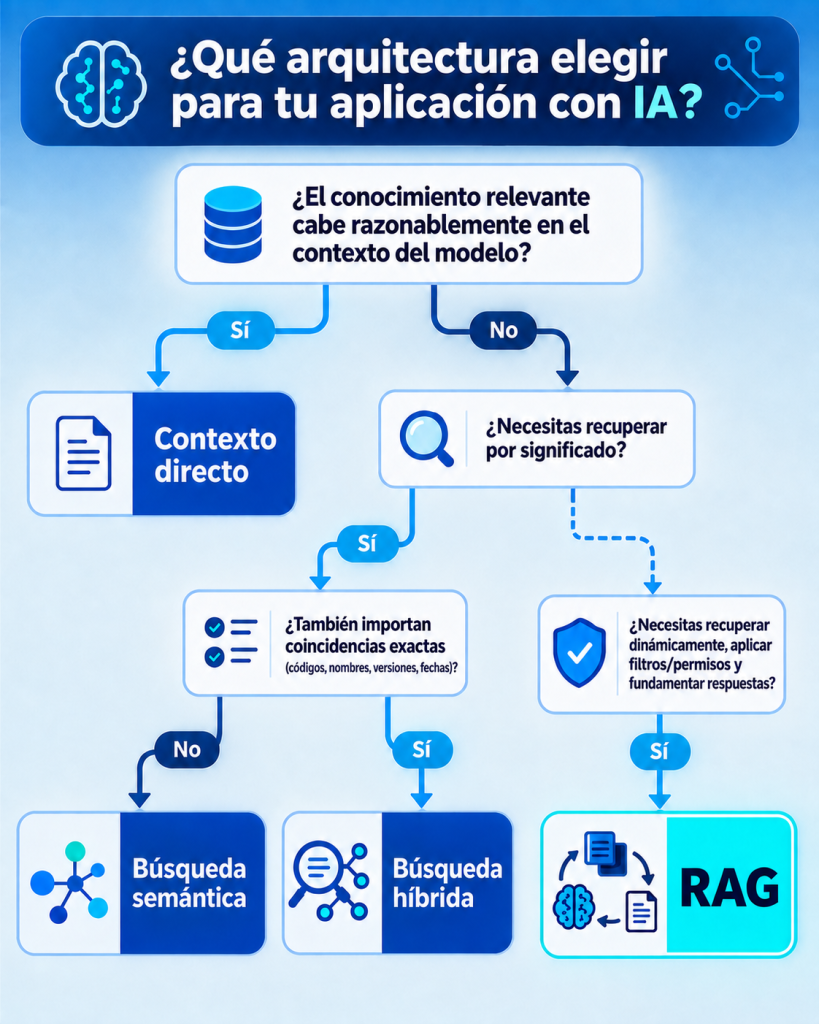
Una forma práctica de decidir es comenzar por la opción más sencilla y aumentar complejidad únicamente cuando los requisitos lo justifiquen.
Usa contexto directo cuando…
El conocimiento necesario es acotado, relativamente estable y cabe de forma económica en cada interacción.
Es especialmente útil para prototipos, análisis de documentos concretos y procesos donde casi todo el corpus es relevante para cada consulta.
Usa búsqueda semántica cuando…
Necesitas localizar información por significado sobre un corpus amplio y las coincidencias conceptuales son más importantes que las literales.
También sirve cuando el producto final es un buscador y no necesariamente una respuesta generada.
Usa búsqueda híbrida cuando…
Necesitas significado y precisión lexical.
Es una candidata especialmente fuerte en documentación técnica, catálogos, soporte, normativa y datos empresariales con identificadores, versiones y terminología específica.
Usa RAG cuando…
El corpus es demasiado grande o dinámico para enviarlo completo, necesitas recuperar solamente una parte por petición o requieres control explícito sobre evidencia, filtros, permisos y trazabilidad.
Y recuerda: RAG no obliga a elegir únicamente búsqueda vectorial.
Un RAG puede recuperar mediante:
- SQL
- búsquedas textuales
- vectores
- búsqueda híbrida
- APIs
- grafos
- herramientas especializadas
- o una combinación de varias fuentes
En producción, probablemente acabarás con una arquitectura híbrida
Las fronteras entre estos patrones se están haciendo menos rígidas. Una aplicación puede mantener instrucciones y documentación fundamental en contexto directo, consultar mediante búsqueda híbrida una base documental extensa, recuperar datos operacionales mediante SQL y entregar finalmente todas esas evidencias al mismo modelo. Ese diseño sigue siendo RAG en sentido amplio, pero su arquitectura de recuperación es mucho más sofisticada que «embeddings + base vectorial».
Por eso conviene pensar en capas:
1. Fuente de verdad
¿Dónde vive realmente la información?
2. Selección
¿Cómo determinamos qué información necesita esta consulta?
3. Autorización
¿Qué parte de esa información puede conocer este usuario?
4. Ranking
¿Qué evidencia es más relevante?
5. Contexto
¿Cuánto de esa evidencia enviamos al modelo?
6. Generación
¿Cómo obligamos al sistema a distinguir entre evidencia disponible y conocimiento no fundamentado?
7. Evaluación
¿Cómo sabemos que funciona?
La arquitectura se elige con evaluaciones, no con intuición
Antes de decidir que una arquitectura es mejor, crea un conjunto de preguntas representativas de producción.
Incluye consultas fáciles y difíciles:
- Preguntas semánticas.
- Términos exactos.
- Acrónimos.
- Información distribuida entre varios documentos.
- Documentos similares pero pertenecientes a versiones diferentes.
- Preguntas sin respuesta.
- Contenido que el usuario no puede consultar.
Después mide al menos:
Recall de recuperación: ¿apareció la evidencia correcta entre los candidatos?
Precisión del ranking: ¿la evidencia correcta quedó suficientemente arriba?
Groundedness: ¿la respuesta se apoya en las fuentes recuperadas?
Latencia: ¿cuánto tarda cada etapa?
Coste: ¿cuánto cuesta ingestión, almacenamiento, búsqueda, reranking y generación?
Mantenibilidad: ¿qué infraestructura tendrá que operar el equipo durante los próximos años?
El patrón más sofisticado no siempre gana.
Una solución con contexto directo puede superar a un RAG mal diseñado.
Una búsqueda keyword bien configurada puede resolver mejor determinados dominios que una base vectorial.
Y una buena búsqueda híbrida puede evitar múltiples capas de complejidad posterior.
Conclusión
RAG sigue siendo una de las arquitecturas más útiles para construir aplicaciones sobre conocimiento empresarial, pero ya no debería ser el punto de partida automático.
Empieza por una pregunta más sencilla:
¿Qué necesita el modelo para responder correctamente y cuál es la forma más eficiente de proporcionárselo?
Si toda la información necesaria cabe razonablemente en el contexto, empieza por contexto directo.
Si necesitas recuperar por significado, prueba búsqueda semántica.
Si tu dominio mezcla significado con coincidencias exactas, evalúa búsqueda híbrida.
Si el corpus crece, cambia constantemente, requiere permisos y necesitas seleccionar evidencia dinámica, construye RAG.
Y solo después añade chunking avanzado, múltiples índices, rerankers, agentes o pipelines adicionales.
Porque una buena arquitectura de IA no es la que incorpora más componentes.
Es la que consigue la evidencia correcta, para la consulta correcta, con el coste, la latencia y la complejidad adecuados.
REFERENCIAS
- Long context | Gemini API | Google AI for Developers — https://ai.google.dev/gemini-api/docs/long-context — Documentación oficial sobre ventanas de contexto largas, casos de uso, caching, costes, latencia y limitaciones.
- Hybrid Search Overview | Azure AI Search | Microsoft Learn — https://learn.microsoft.com/en-us/azure/search/hybrid-search-overview — Documentación oficial sobre búsqueda híbrida, combinación de texto y vectores y Reciprocal Rank Fusion.
- Create a Hybrid Query | Azure AI Search | Microsoft Learn — https://learn.microsoft.com/en-us/azure/search/hybrid-search-how-to-query — Guía oficial actualizada sobre consultas híbridas y semantic ranking.
- Contextual Retrieval in AI Systems | Anthropic — https://www.anthropic.com/engineering/contextual-retrieval — Fuente técnica original sobre Contextual Embeddings, Contextual BM25 y problemas de pérdida de contexto en RAG tradicional.
- Retrieval Augmented Generation (RAG) for Projects | Anthropic Help Center — https://support.anthropic.com/en/articles/11473015-retrieval-augmented-generation-rag-for-projects — Ejemplo actual de uso práctico de RAG para escalar conocimiento más allá de la ventana de contexto.
- Vector store files | OpenAI API Reference — https://platform.openai.com/docs/api-reference/vector-stores-files — Referencia oficial sobre archivos en vector stores utilizados por herramientas de recuperación como File Search.